AI Agent 全解析:用 LangGraph 构建多步骤 Agent 工作流——状态、条件边与中断恢复
手写循环通常崩在第三步
上一篇(LangChain vs CrewAI vs AutoGPT)结尾留了一句:进代码,看状态怎么定义、条件边怎么写、checkpoint 怎么落盘。这篇就来兑现。
先说手写 while 循环的真实死法。它几乎从不"跑不起来",它是跑到第三步的时候,你不知道自己在哪。
一开始代码是这样:一个 state 大 dict,一个 step 字符串标记进度,重试写在 if 里,工具报错就 try/except 吞掉继续。前两步很顺。第三步开始出三种症状:state 里的字段互相打架——draft 是第二稿、review 却是第一稿的结论;一重跑就得从头来——前面几步的 token 和工具调用全白花;停不下来——终止判据是模型自己在 prompt 里说"完成了",而不是系统验的。
LangGraph 的解法不神秘,它就是把这三种隐式的东西显式化:State 是一个有类型的结构、Node 是纯函数、Edge 是连通关系。控制流从提示词里搬到了代码里,于是它变得可以打印、可以落盘、可以回放。
StateGraph 的三件套:State、Node、Edge
先看一张全图,后面每一段都对应图里的某个位置:
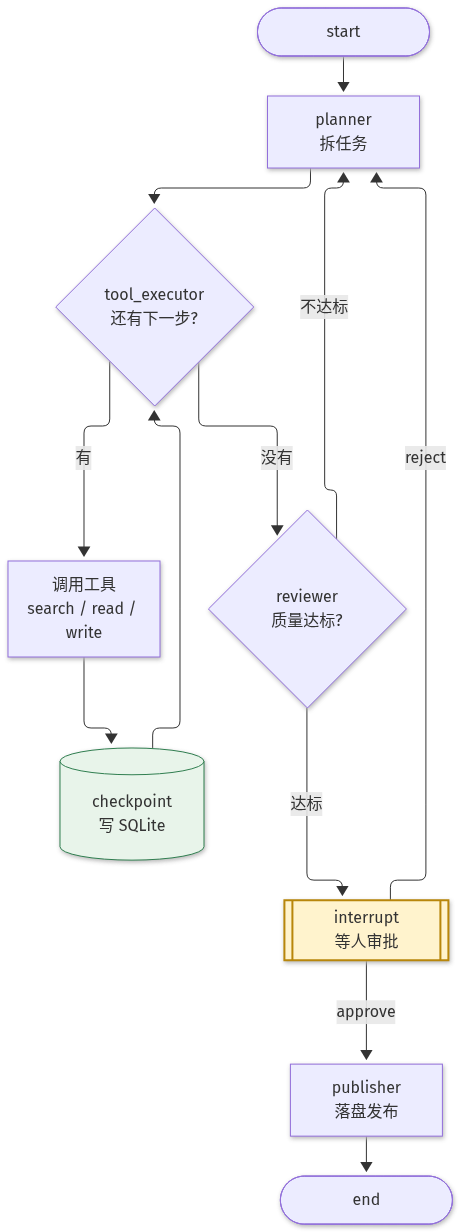
三个零件,各自只有一条规则需要记:
State 决定"什么被记住",以及"怎么合并"。 节点不返回完整 state,只返回增量;字段怎么合并由类型上的 Annotated 决定。默认行为是覆盖,列表想累加就得显式写 operator.add。这一条是新手最容易摔的地方,后面还会提。
Node 是 (state) -> dict 的纯函数。 它不该自己决定"下一步去哪"——那是边的事。把路由逻辑写进节点,等于又回到了 if-else 的老路。
Edge 分两种。 add_edge 是固定边;add_conditional_edges 是条件边,路由函数只读 state,返回一个字符串 key,由 mapping 决定去哪个节点。循环就是条件边指回上游——没有 while。
from typing import TypedDict, Annotated
import operator
from langgraph.graph import StateGraph, START, END

class BlogState(TypedDict):
    topic: str
    outline: str
    draft: str
    review: str
    attempts: int
    approved: bool
    log: Annotated[list, operator.add]   # 不加这个,后面节点的 log 会覆盖前面

g = StateGraph(BlogState)
for name, fn in [("planner", planner), ("writer", writer),
                 ("reviewer", reviewer), ("gate", human_gate),
                 ("publisher", publisher)]:
    g.add_node(name, fn)

g.add_edge(START, "planner")
g.add_edge("planner", "writer")
g.add_edge("writer", "reviewer")
g.add_conditional_edges("reviewer", route_after_review,
                        {"gate": "gate", "writer": "writer"})   # 不达标 → 打回重写
g.add_conditional_edges("gate", route_after_gate,
                        {"publisher": "publisher", "writer": "writer"})
g.add_edge("publisher", END)
实战:改稿 → 审核 → 人工审批 → 发布
为什么挑这个场景?因为它是"多步骤 + 可能被打回 + 必须有人批"的最小真实形态——也是我每天真正在跑的东西。换成客服工单、合同生成、报表产出,结构完全一样。
节点都不长,关键是它们的职责边界:
def planner(state: BlogState):
    return {"outline": fake_llm("outline", ""), "log": ["planner:4 段提纲"]}

def writer(state: BlogState):
    draft = fake_llm("draft", state["topic"])
    if state["attempts"] == 0:
        draft += " TODO: 补结论"                 # 故意留个缺陷给 reviewer 抓
    return {"draft": draft, "attempts": state["attempts"] + 1,
            "log": [f"writer:第 {state['attempts'] + 1} 稿,{len(draft)} 字"]}

def reviewer(state: BlogState):
    verdict = json.loads(fake_llm("review", state["draft"]))
    return {"review": verdict["reason"], "log": [f"reviewer:{verdict['reason']}"]}

def route_after_review(state: BlogState):
    return "gate" if state["review"] == "结构完整" else "writer"

def human_gate(state: BlogState):
    decision = interrupt({"draft": state["draft"], "review": state["review"]})
    return {"approved": decision == "approve", "log": [f"human:{decision}"]}

def route_after_gate(state: BlogState):
return "publisher" if state["approved"] else "writer"为了看清编排本身,我把模型换成一个按剧本回话的假函数(否则每次输出都不一样,没法对照)。跑的是真的 LangGraph,只有 LLM 是假的:
=== 第一次运行:跑到 interrupt 停下 ===
__interrupt__ = {"draft": "《LangGraph 实战》:状态图把控制流从提示词里拿出来。", "review": "结构完整"}
log = ['planner:4 段提纲', 'writer:第 1 稿,41 字', 'reviewer:缺结论',
       'writer:第 2 稿,31 字', 'reviewer:结构完整']
next = ('gate',) | checkpoint 里的 attempts = 2
三行输出,三个信息。
一,log 里 writer 出现了两次。 第一次被 reviewer 拒了("缺结论"),条件边把控制流打回 writer,attempts 从 1 变成 2,第二稿补上结论才通过。整个过程没有一行 while、没有一行业务 if——重试是图的结构带来的。
二,它停住了,而且是停在 gate 这个节点上。 next = ('gate',) 是 LangGraph 提前告诉你"我下一步要去哪",不是"我出错了"。这时进程可以正常退出,内存全丢也不影响。
三,state 是完整的。 attempts = 2、draft 是第二稿、log 有三条——不是靠变量在内存里活着,是靠 checkpoint 里存着。
interrupt + checkpointer:把"等人"变成一等公民
这是 LangGraph 相对其他框架唯一没法替代的能力,值得单独一张时序图:
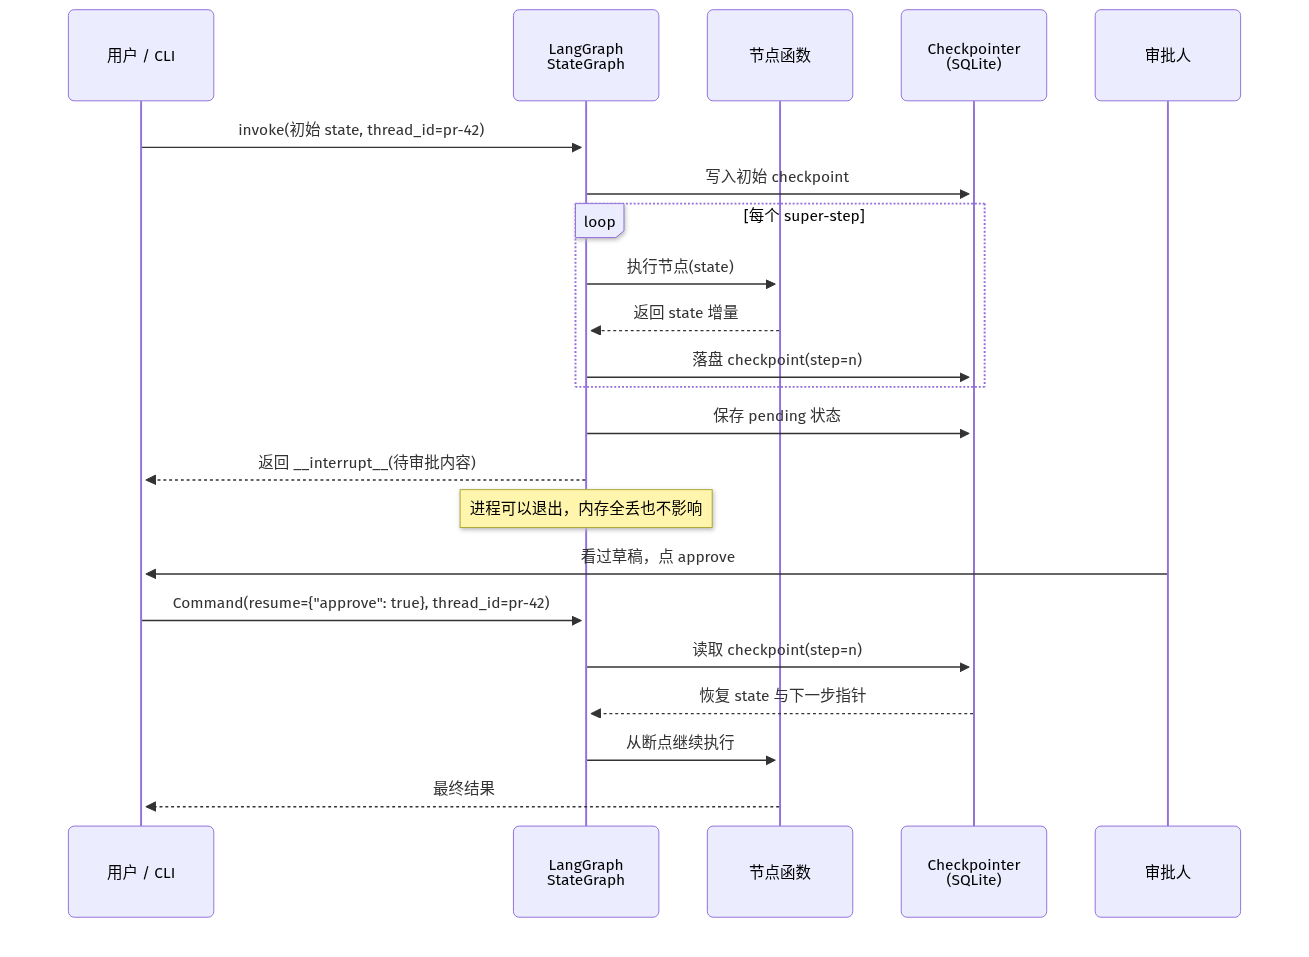
interrupt() 不是抛异常绕过控制流,它是把当前 state 落盘、把执行指针停在节点内部、然后把值返回给调用方。调用方拿着同一个 thread_id 发 Command(resume=...),图从那个指针继续,返回值成为 interrupt() 的返回值。
# 第一次:跑到 gate 就返回
out = app.invoke({"topic": "LangGraph 实战", "attempts": 0,
                  "approved": False, "log": []},
                 {"configurable": {"thread_id": "post-42"}})

# 第二次:可能是几分钟后、另一个进程、另一台机器
out2 = app.invoke(Command(resume="approve"),
                  {"configurable": {"thread_id": "post-42"}})
真实输出:
log = ['planner:4 段提纲', 'writer:第 1 稿,41 字', 'reviewer:缺结论',
       'writer:第 2 稿,31 字', 'reviewer:结构完整',
       'human:approve', 'publisher:写入 posts/ 并 push']
approved = True | LLM 调用总数 = 5

=== 第三次:换 thread_id 重跑但审批打回 ===
log = [... 'human:reject', 'writer:第 3 稿,31 字', 'reviewer:结构完整']
再次停在 = ('gate',)
注意第二次运行的 log:它从 human 接着往下走,planner 和 writer 一个都没重跑,LLM 调用总数停在 5。这就是 checkpoint 的实际价值——审批等待不烧 token。如果你用的是"整条链路重跑一遍再带上审批意见"的土办法,等一夜的成本够你跑一百次。
第三次更有意思:审批打回后,图回到 writer 写第三稿,然后又停在 gate 等下一次审批。被打回不是异常路径,是正常路径的一部分——这一点在需求评审里几乎必然发生,但很多工作流框架压根没给它建模。
demo 用的是 InMemorySaver,生产必须换 SqliteSaver 或 PostgresSaver。 换成持久化 saver 只需要改一行 compile(checkpointer=...),但语义完全不同:前者进程一死全丢,后者才是真正的"明天早上接着审"。thread_id 就是主键,通常直接用业务 ID(订单号、PR 号、工单号),不要用随机 uuid——否则你找不到那条待审批的任务。
三个我踩过的坑
一、state 只增不减,checkpoint 把磁盘吃干净。 我第一版把抓下来的网页正文、整个文件内容全塞进 state,每个 super-step 都存一份完整快照。SQLite 一天涨到 800MB,而且每次读 checkpoint 都要反序列化一大坨。改法很朴素:state 只放"做决策需要的东西",大对象放外部,state 里只存引用(文件路径、对象存储 key、数据库 id)。节点要用正文就现读,别让它躺在 state 里被复制十几遍。
二、reducer 忘写,你以为节点没执行,其实是被覆盖了。 log、messages、errors 这类累加字段,不写 Annotated[list, operator.add],后一个节点返回的 list 会整个替换前一个。表现是"我明明加了日志,怎么只剩最后一条"——排查方向会一路歪到节点没被调用上去。规则:字段名是复数的,先想合并策略。
三、条件边返回了不存在的 key,报错指向 mapping。 路由函数返回 "publish",mapping 里写的却是 "publisher",报错信息指向 add_conditional_edges 那一行的字典,而不是那个写错字符串的函数。十分钟起步。改法:路由函数的返回值用常量,或者干脆让它返回 Literal["gate", "writer"] 让类型检查器替你抓。
和 CrewAI 的分界线在哪
上一篇的结论在这里可以落地成一个判断句:需不需要"停在中途"。
CrewAI 的 sequential 是一条直线跑到黑,跑完才把结果还给你;LangGraph 的图可以有环、可以停在节点内部、可以从任意 checkpoint 回放。反过来,如果流程真的就是 A→B→C 三段、不用人批、不用续跑,那 LangGraph 的样板代码(一个 State、五个 add_node、四条边)会比 CrewAI 多一倍,而收益是零。
我的判断标准是四个词,出现任意一个才值得上状态图:打回重写、等人审批、跑十几分钟、挂了要续上。四个都不沾,直接写个函数顺序调用,比任何框架都强。
一句话
LangGraph 没让 Agent 变聪明,它只是把 while 循环里那些隐式变量——现在第几步、state 是什么、下一步走哪——变成了能打印、能落盘、能回放的东西。 调 Agent 最难的部分从来不是模型不够强,是你不知道它当时在想什么。
下一篇回到工具侧:Cline + Aider,两个开源代码 Agent——一个活在编辑器里,一个活在终端里,看它们各自把"改代码"这件事拆成了哪几步。
AI Agent 全解析系列:
1. AI Agent 是什么——从 LLM 到自主智能体的进化
2. Agent 的四大核心能力:规划、记忆、工具、执行
3. 2026 AI Agent 全景图:谁在做什么,谁能用
4. 选 Agent 还是选 Copilot?不同场景的决策框架
5. Agent 的架构模式:ReAct、Plan-Execute、Multi-Agent
6. 工具调用深度解析:Function Calling、MCP 协议与插件生态
7. Agent 的记忆系统:短期记忆、长期记忆与 RAG
8–10. Hermes Agent 入门 / 配置 / Skills(从这里开始)
11. LangChain vs CrewAI vs AutoGPT:三个框架把复杂度藏在了哪里
12. 👉 用 LangGraph 构建多步骤 Agent 工作流(本文)
💬 Comments