AI Agent 全解析:Agent 的架构模式——ReAct、Plan-Execute、Multi-Agent
先把「架构」这个词拉回地面
上一篇(选 Agent 还是选 Copilot)聊的是方向盘交给谁。这篇往下钻一层:假设已经决定让 Agent 掌舵,那它内部的骨架到底长什么样?
关于 Agent 的讨论特别喜欢谈「能力」——会不会用工具、记不记得住、能不能自我纠错。但能力是零件,架构是把零件装起来的方式。同一套零件,装法不同,能干的活完全不同。三种最常见的装法:ReAct、Plan-Execute、Multi-Agent。
先给结论:这三种不是「谁更高级」的排序,而是回答三个不同问题的答案。
- ReAct 回答:不知道下一步该干嘛的时候,怎么办?
- Plan-Execute 回答:步骤已知的时候,怎么跑得省、跑得稳?
- Multi-Agent 回答:一件事太长太杂,怎么拆给多个角色去做?
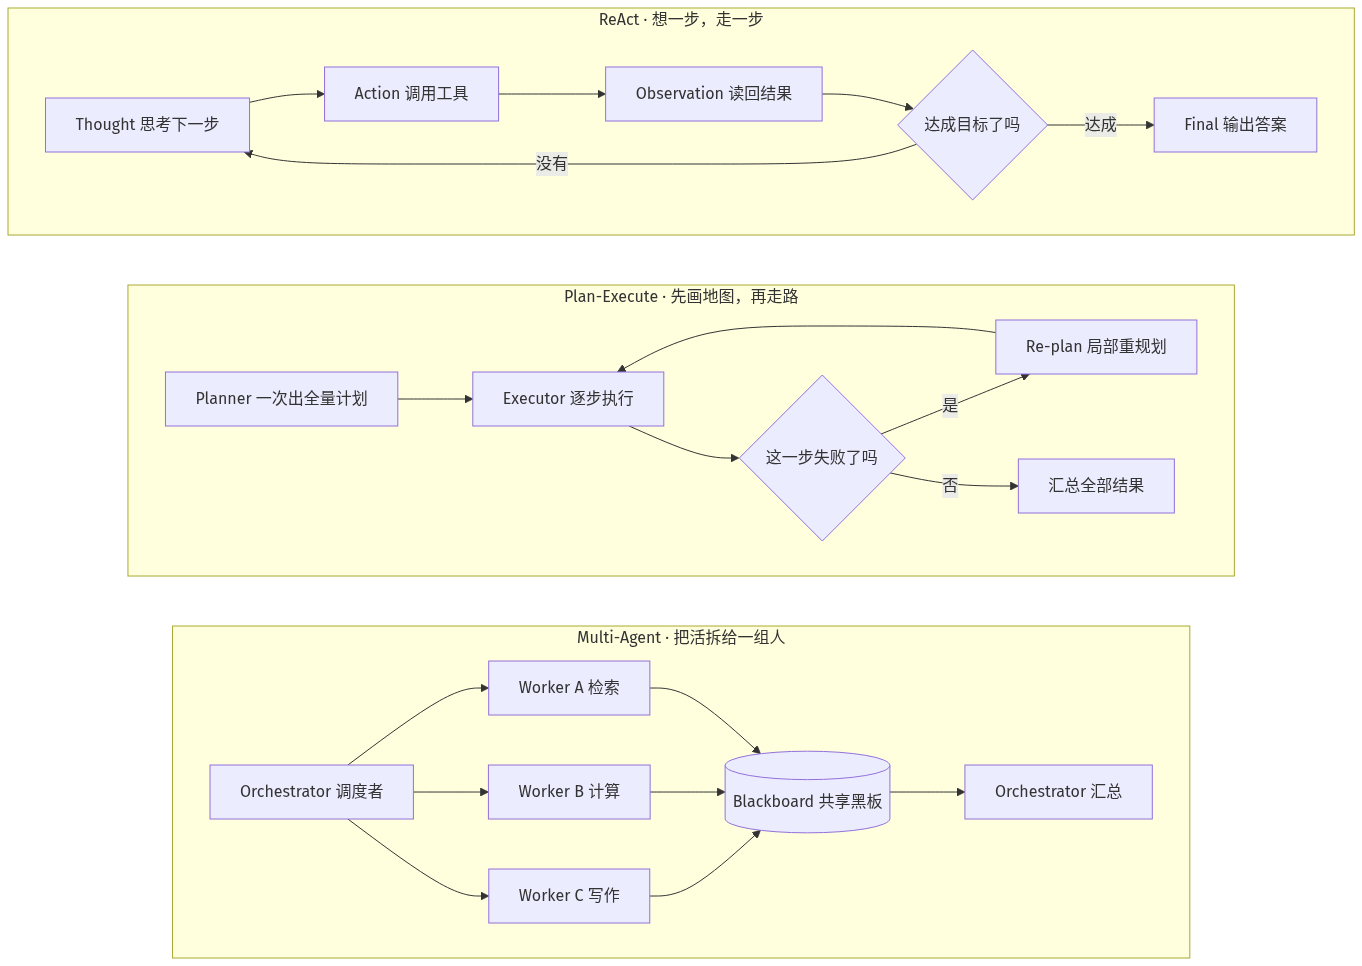
图先摆上,后面逐个拆。
ReAct:想一步,走一步
ReAct 是最小、也最通用的骨架。名字来自 2022 年那篇同名论文,把 Reasoning 和 Acting 缝在一起:模型先输出一段思考(Thought),决定要调哪个工具(Action),拿到工具的返回(Observation),再根据返回继续思考。循环到目标达成为止。
关键在于:下一步永远是在看到上一步结果之后才决定的。 它不是先想好全部再动手,而是走一步看一步。
好处是灵活。信息不全、路径不明、需要探索的任务,ReAct 几乎是唯一解——因为你根本没法提前写出计划。Debugging 就是典型:在看到报错之前,你根本不知道下一步该查哪里。
代价也很直接:每一次思考都是一次模型调用。 步骤越多,调用越多,延迟和成本线性上升;而且中间任何一步想歪了,后面就跟着歪——它没有「重新规划」这个动作能把方向拉回来,只能继续在错的方向上迭代。
Plan-Execute:先画地图,再走路
Plan-Execute 把循环拆成两段。第一段 Planner 一次性产出完整计划:几步、每步调什么工具、用什么参数。第二段 Executor 拿着计划逐步执行,中途不再问模型「下一步干嘛」——因为它已经知道。
这带来两个 ReAct 给不了的好处:
- 省钱。 规划只调一次模型,执行阶段全是确定性的工具调用,没有额外的推理开销。
- 能并行、能审查。 计划是一份看得见的东西——人可以先过一眼,可以拿去做成本估算,也可以让其中几步同时跑。
但它有一个致命假设:计划是对的。 真实世界里计划经常是错的——某个键名记错了、某个接口挂了、某份数据根本不存在。所以一个能用的 Plan-Execute 必须带兜底:执行到某步失败时触发 Re-plan,只改失败的那一步,而不是推倒整条计划重来。这一步「局部重规划」,就是 Plan-Execute 和「一次性脚本」的分水岭。
Multi-Agent:把活拆给一组人
当一件事长到单个 Agent 的上下文装不下、或者需要几种完全不同的角色时,就轮到 Multi-Agent。一个 Orchestrator(调度者)先把目标拆成子任务,分派给若干 worker;各个 worker 自己跑自己的循环,结果通过一块共享黑板(Blackboard)或消息队列交接,最后由调度者汇总。
它的诱惑力在于「像团队一样工作」,但它也是三种里最容易翻车的:
- 沟通成本爆炸。 两个 worker 之间每多一次交接,就多一次信息损耗。三个 worker 不是三倍效率,可能是三倍的扯皮。
- 错误会被放大。 worker A 检索错了,worker B 基于错数据去算,worker C 把错结论写得很漂亮——最后交付一份自信的错误。
- 调试变难。 单 Agent 出问题,看一条 trace;Multi-Agent 出问题,得看一张通信图。
所以 Multi-Agent 的适用边界很窄:子任务真的独立、真的需要不同角色、真的能并行。 只是为了「显得高级」而拆成多 Agent,是最常见的过度设计。
三者的区别,一句话说清
把三种架构放进同一张表,差别就落在「谁在决定下一步」这一列:
| 架构 | 谁决定下一步 | 模型调用 | 最擅长 | 最容易死在哪 |
|---|---|---|---|---|
| ReAct | 每一步都问模型 | 随步数线性增长 | 探索、调试、信息不全 | 步骤一多就贵;走歪了拉不回来 |
| Plan-Execute | 开头只问一次 | 规划 1 次 + 失败时重规划 | 步骤清晰、批量重复 | 计划本身就是错的,又没有兜底 |
| Multi-Agent | 拆解时问一次,worker 各自决定 | 调度 + 每个 worker 各自计数 | 长链路、多来源、可分工 | 沟通开销和错误放大 |
读这张表只需要盯一列:决定权在谁手里。 ReAct 每一步都问模型;Plan-Execute 只在最开始问一次;Multi-Agent 则是把「问」这件事分摊给几个各自为战的 Agent。决定权越往下放,越灵活,也越贵、越难控。
实战:同一道题,三种跑法
道理讲再多不如跑一遍。下面这段代码用同一组工具、同一道题(查两年的市场规模、算增长率、写一句结论),分别用三种架构各跑一遍,把每一步的 trace 打出来。为了不依赖任何模型 API,我用一个确定性的决策函数代替 LLM——控制流才是主角,模型只是那个拿主意的角色。
#!/usr/bin/env python3
"""AI Agent 全解析 · 05 配套代码
三种架构模式的最小可运行实现:ReAct / Plan-Execute / Multi-Agent。

不调任何真实模型——用一个确定性的「决策函数」代替 LLM,
把注意力全放在控制流上:谁来决定下一步、循环在哪里收口、出错谁来兜。

运行:python3 agent_patterns.py
"""
from __future__ import annotations

KB = {"agent_market_2025": 52.0, "agent_market_2026": 78.0}
SCRATCH: list[str] = []


def _search(key):
    if key not in KB:
        raise KeyError(f"知识库里没有 {key}")
    return KB[key]


def _calc(expr):
    return round(eval(expr, {"__builtins__": {}}, {}), 2)


def _write(text):
    SCRATCH.append(text)
    return text


TOOLS = {"search": _search, "calc": _calc, "write": _write}


class Trace:
    """记录一次运行:决策几次、调了几次工具、每一步留下了什么。"""

    def __init__(self, name):
        self.name = name
        self.steps = []
        self.llm_calls = 0
        self.tool_calls = 0

    def decide(self, decision):
        self.llm_calls += 1
        return decision

    def act(self, tool, args):
        obs = TOOLS[tool](**args)
        self.tool_calls += 1
        self.steps.append((tool, args, obs))
        return obs

    def dump(self):
        print(f"\n=== {self.name} ===")
        for i, (tool, args, obs) in enumerate(self.steps, 1):
            print(f"  {i:>2}. {tool}({args}) -> {obs}")
        print(f"  决策次数={self.llm_calls}  工具调用={self.tool_calls}  步骤={len(self.steps)}")


def react(trace):
    """ReAct:每一步都重新「想一下」再决定动作,观测回来后继续想。"""
    mem = {}
    while True:
        if "m2025" not in mem:
            d = trace.decide(("act", "search", {"key": "agent_market_2025"}, "m2025"))
        elif "m2026" not in mem:
            d = trace.decide(("act", "search", {"key": "agent_market_2026"}, "m2026"))
        elif "growth" not in mem:
            expr = f"({mem['m2026']}-{mem['m2025']})/{mem['m2025']}*100"
            d = trace.decide(("act", "calc", {"expr": expr}, "growth"))
        else:
            d = trace.decide(("final", f"2026 年市场规模较 2025 年增长 {mem['growth']}%", None, None))
        if d[0] == "final":
            trace.steps.append(("final", {}, d[1]))
            return d[1]
        _, tool, args, key = d
        mem[key] = trace.act(tool, args)


def _fill(args, mem):
    """把计划里的占位符 {m2025} 换成前几步攒下的真实结果。"""
    return {k: (v.format(**mem) if isinstance(v, str) else v) for k, v in args.items()}


def plan_execute(trace):
    """Plan-Execute:先一次性出计划,再逐步执行;执行期发现计划有误则重规划。"""
    trace.llm_calls += 1  # 规划本身算一次模型调用
    plan = [
        {"tool": "search", "args": {"key": "agent_market_2025"}, "save": "m2025"},
        {"tool": "search", "args": {"key": "agent_market_2026_q1"}, "save": "m2026"},  # 计划里的错误假设
        {"tool": "calc", "args": {"expr": "({m2026}-{m2025})/{m2025}*100"}, "save": "growth"},
        {"tool": "write", "args": {"text": "增长 {growth}%"}, "save": "out"},
    ]
    mem, i = {}, 0
    while i < len(plan):
        step = plan[i]
        try:
            val = trace.act(step["tool"], _fill(step["args"], mem))
        except KeyError as e:
            trace.llm_calls += 1  # 兜底重规划,也是一次模型调用
            if "agent_market_2026_q1" in str(e):
                plan[i] = {"tool": "search", "args": {"key": "agent_market_2026"}, "save": "m2026"}
                trace.steps.append(("REPLAN", {}, "错误的键改成 agent_market_2026,重跑该步"))
                continue
            raise
        mem[step["save"]] = val
        i += 1
    return mem["out"]


def multi_agent(trace):
    """Multi-Agent:调度者拆活,worker 各跑各的,靠共享黑板交接。"""
    trace.llm_calls += 1  # 调度者拆解任务
    board = {}
    # researcher worker:两次检索
    for key in ("agent_market_2025", "agent_market_2026"):
        trace.llm_calls += 1  # 每个 worker 自己也要决策
        board[key] = trace.act("search", {"key": key})
    # analyst worker:一次计算
    trace.llm_calls += 1
    board["growth"] = trace.act(
        "calc",
        {"expr": f"({board['agent_market_2026']}-{board['agent_market_2025']})"
                 f"/{board['agent_market_2025']}*100"},
    )
    # writer worker:产出
    trace.llm_calls += 1
    board["out"] = trace.act("write", {"text": f"增长 {board['growth']}%"})
    return board["out"]


if __name__ == "__main__":
    for fn, name in ((react, "ReAct"), (plan_execute, "Plan-Execute"), (multi_agent, "Multi-Agent")):
        t = Trace(name)
        answer = fn(t)
        print(f"[{name}] 最终答案:{answer}")
        t.dump()
跑出来的真实输出:
[ReAct] 最终答案:2026 年市场规模较 2025 年增长 50.0%

=== ReAct ===
   1. search({'key': 'agent_market_2025'}) -> 52.0
   2. search({'key': 'agent_market_2026'}) -> 78.0
   3. calc({'expr': '(78.0-52.0)/52.0*100'}) -> 50.0
   4. final({}) -> 2026 年市场规模较 2025 年增长 50.0%
  决策次数=4  工具调用=3  步骤=4
[Plan-Execute] 最终答案:增长 50.0%

=== Plan-Execute ===
   1. search({'key': 'agent_market_2025'}) -> 52.0
   2. REPLAN({}) -> 错误的键改成 agent_market_2026,重跑该步
   3. search({'key': 'agent_market_2026'}) -> 78.0
   4. calc({'expr': '(78.0-52.0)/52.0*100'}) -> 50.0
   5. write({'text': '增长 50.0%'}) -> 增长 50.0%
  决策次数=2  工具调用=4  步骤=5
[Multi-Agent] 最终答案:增长 50.0%

=== Multi-Agent ===
   1. search({'key': 'agent_market_2025'}) -> 52.0
   2. search({'key': 'agent_market_2026'}) -> 78.0
   3. calc({'expr': '(78.0-52.0)/52.0*100'}) -> 50.0
   4. write({'text': '增长 50.0%'}) -> 增长 50.0%
  决策次数=5  工具调用=4  步骤=4
三处值得盯。
一、ReAct 的模型调用次数随步骤线性增长。 4 步走了 4 次决策、3 次工具调用。任务再长一倍,模型调用也跟着翻倍。这就是 ReAct 的成本结构:灵活,但按步收费。
二、Plan-Execute 的模型调用只有 2 次,工具调用却有 4 次。 规划 1 次,重规划 1 次,剩下全是确定性的执行。它比 ReAct 多跑了一步——因为计划里那个错误的键名(agent_market_2026_q1)先失败了一次,触发了重规划。这个「多出来的一步」,正是 Plan-Execute 值钱的地方:它没有在错的方向上一路走到底,而是在失败点就地修好了。
三、Multi-Agent 的模型调用最多(5 次),工具调用跟 Plan-Execute 一样都是 4 次。 因为它把一次任务拆解、加上每个 worker 各自的决策都算进去了。干了同样的活,沟通开销比谁都大——这就是前面说的「三个 worker 不是三倍效率」。在这道只有四步的小任务上,Multi-Agent 是纯粹的过度设计。
怎么选:一张图定下来
不用背,记一条主线:下一步依赖上一步的结果吗?
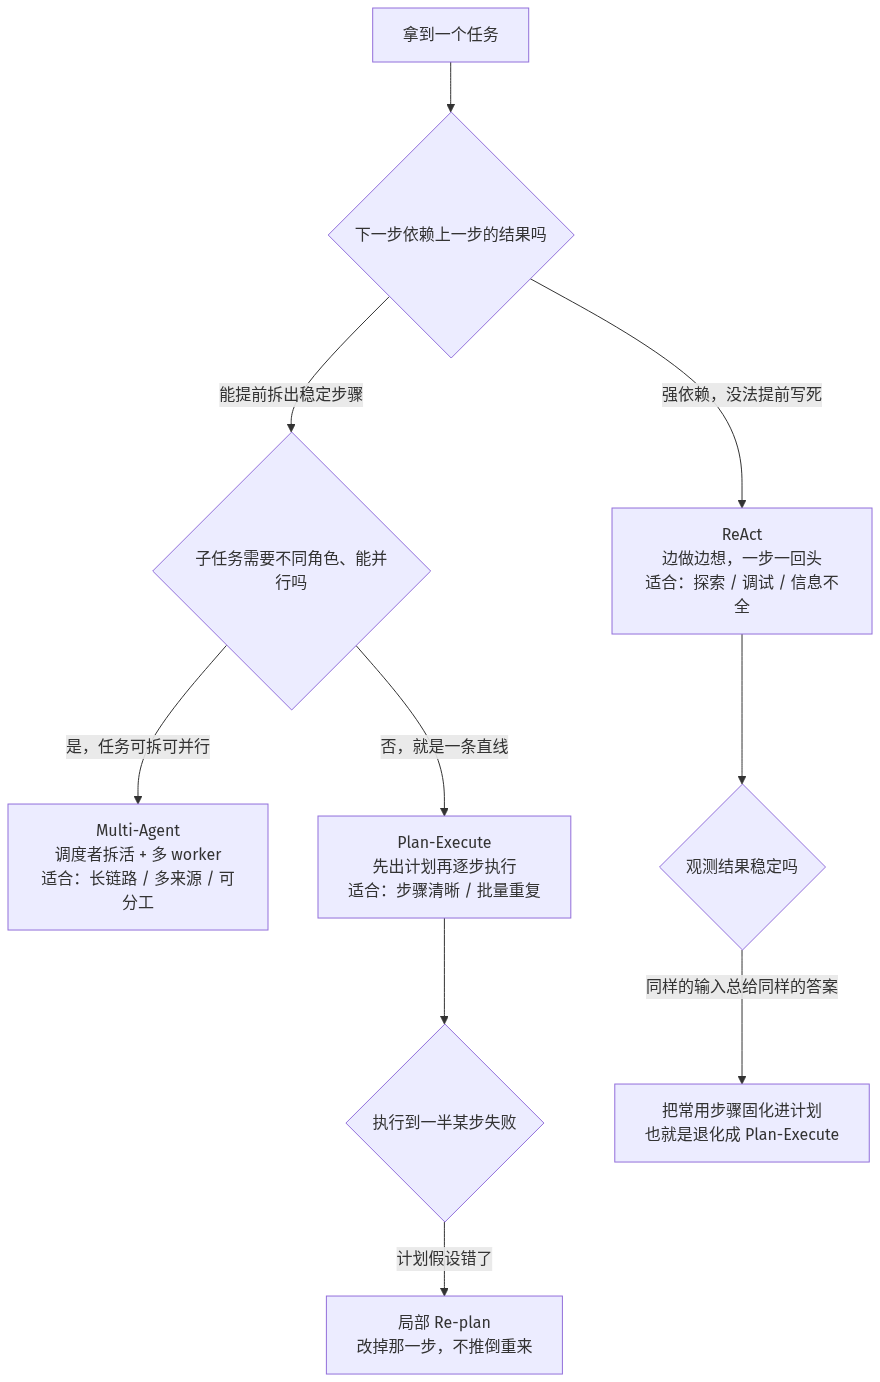
顺序是死的,别跳:
- 强依赖、没法提前写死 → ReAct。 探索、调试、信息不全的场景,先上场的就是它。
- 能提前拆出稳定步骤 → 再问一句:子任务需要不同角色、能并行吗?
- 需要、能并行 → Multi-Agent。 长链路、多数据源、天然可分工的任务。
- 不需要、就一条直线 → Plan-Execute。 步骤清晰、批量重复的活。
还有两个容易忽略的「退化」方向,图里也画了:Plan-Execute 执行失败 → 局部 Re-plan,别重来;ReAct 跑顺了、发现观测结果稳定了 → 把常用步骤固化进计划,也就是把自己退化成 Plan-Execute。 这不是降级,是成熟——一个任务从「每次都要重新探索」进化到「照着计划跑」,正是它被吃透的标志。
三个反直觉的结论
一、越灵活的架构越贵,但贵不等于好。 ReAct 每一步都在重新决策,所以它能在陌生任务上不迷路;也正因为如此,它在一个已经摸清套路的任务上就是纯粹的浪费。把跑顺的 ReAct 固化下来,是省钱的第一步。
二、Plan-Execute 的价值不在「计划」,在「重规划」。 一次性脚本也能出计划。真正把 Plan-Execute 和脚本区分开的,是执行失败时它知道就地修正,而不是崩溃、也不是硬着头皮往下跑。一个好的 Plan-Execute,工程量的大头都花在那个 catch 分支上。
三、Multi-Agent 是最后才考虑的选项,不是最强的选项。 它的每一步成本都比单 Agent 高,收益却只在「任务真的可拆可并行」时才出现。多数人第一反应是「多上几个 Agent 会不会更聪明」,正解通常相反:先用一个 Agent 把循环跑通,跑不动了,再按确实存在的分工线切开。
顺带一句:这三种架构都绕不开同一根管子——工具调用。ReAct 的 Action、Plan-Execute 的每一步执行、Multi-Agent 里 worker 之间交接的活,最终都要落到「怎么把一个决策变成一次真实的函数调用」上。
记住这一件事
一句话:三种架构的差别,全在「谁来决定下一步」。 ReAct 每步都问模型,灵活但按步收费;Plan-Execute 只在开头问一次,省,但有赖于局部重规划兜底;Multi-Agent 把决策分摊给几个角色,能力上限最高,沟通成本也最高。选架构的方法不是选最强的,是选那个「下一步由谁决定」最省事、又最不容易出错的。
下一篇往下再钻一层,专讲这根管子:工具调用——Function Calling 到底怎么把一句自然语言变成一个函数调用、MCP 协议想统一什么、插件生态现在长什么样。
AI Agent 全解析系列:
1. AI Agent 是什么——从 LLM 到自主智能体的进化
2. Agent 的四大核心能力:规划、记忆、工具、执行
3. 2026 AI Agent 全景图:谁在做什么,谁能用
4. 选 Agent 还是选 Copilot?不同场景的决策框架
5. 👉 Agent 的架构模式:ReAct、Plan-Execute、Multi-Agent(本文)
6. 工具调用深度解析:Function Calling、MCP 协议与插件生态(下一篇)
💬 Comments