AI Agent 全解析:选 Agent 还是选 Copilot?不同场景的决策框架
先把问题问对:这不是「谁更强」
「该选 Agent 还是选 Copilot?」这个问题被问得越来越多,但多数人把它当成了「选哪款产品」。其实两者不在同一个坐标轴上。Cursor 里可以开 Agent 模式,也可以关掉只用 Tab 补全;Claude Code 默认是 Agent,你也可以把它当补全器用。买哪家是另一回事——真正的选择是:这个任务,方向盘交给谁。
一句话区分这两件事:
- Copilot:你在环内。 它提议,你决定。你每按一次 Tab,就是一次验收。
- Agent:你在环外。 你只在开头设边界、在结尾验收,中间十几步由它自己走。
分界线不在「谁更聪明」,而在「每一步走完之后,谁来告诉它对不对」。这句话在第 03 篇(2026 AI Agent 全景图)里出现过,那时它用来给整个 Agent 市场分层。这篇把它落回到一次具体的分工上。
两条回路:一张图看懂区别
不用比喻,把两者的循环画出来,差别就一目了然。
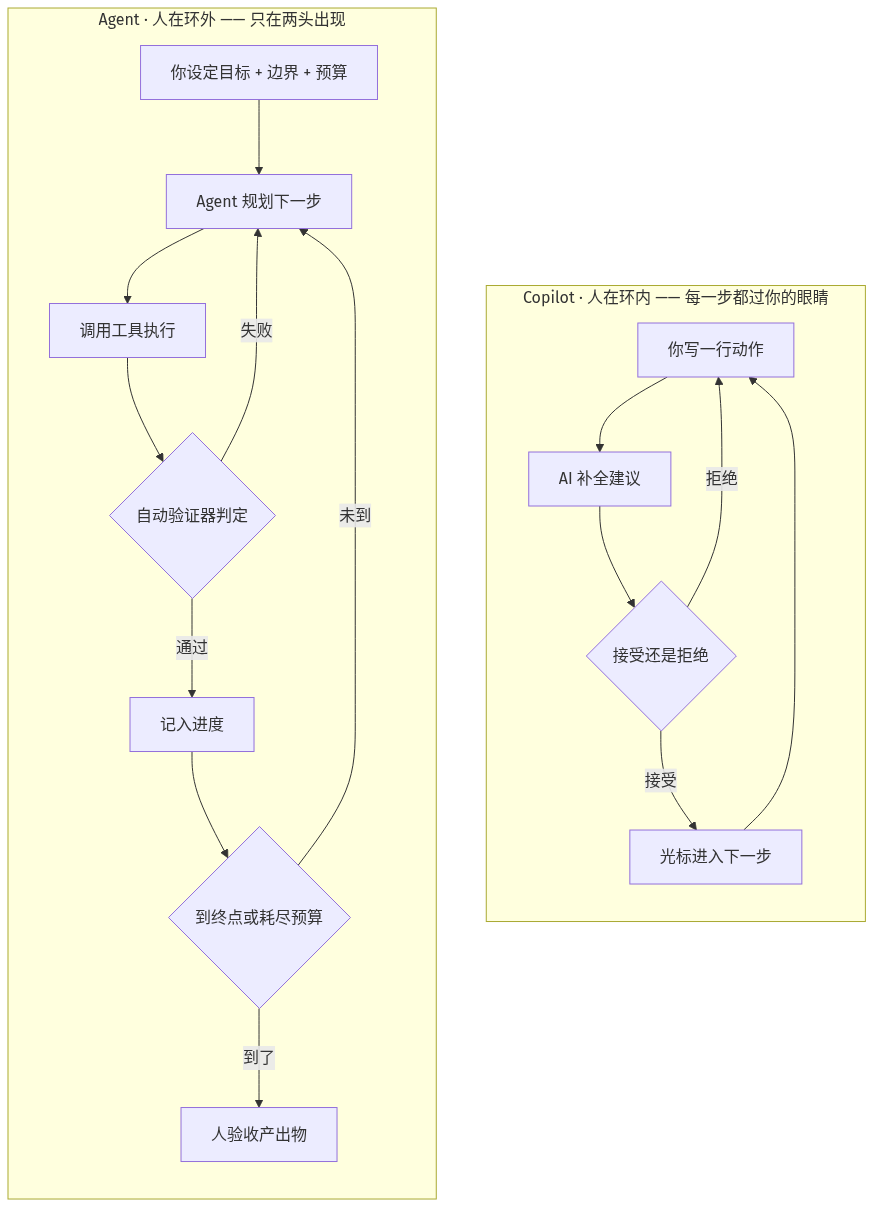
Copilot 的环很短:你写一行动作,它补全,你判断接受还是拒绝,光标进入下一步。环里每一圈都有你。反馈延迟接近零,因为你本身就是验证器。
Agent 的环长得多:规划下一步 → 调用工具 → 自动验证 → 记进度 → 再规划。环里没有你,你只出现在最前面的「设定目标 + 边界 + 预算」和最后面的「验收产出物」。
这里藏着全文的结论:Agent 能不能用,取决于中间那个「自动验证器」存不存在。 有它,环能自己转;没有它,环必然在第三步左右脱轨,然后你就成了一个每三步被叫醒一次的人——那还不如一开始就用 Copilot,至少你一直在场。
五个变量:把「该用谁」变成可算的问题
把直觉拆成可打分的变量,选型就不会凭感觉。五个变量,每个都在两端之间取一个位置:
| 变量 | 偏 Copilot | 偏 Agent |
|---|---|---|
| 产出物能自动验证吗 | 不能,只能靠人看 | 能,编译器 / 测试 / 断言说了算 |
| 出错能撤吗 | 不可逆:发钱、发消息、删数据 | 可重跑,坏了 revert 就行 |
| 任务频次 | 一次性,做完就扔 | 高频,批量大 |
| 你在场吗 | 你在,随时能接管 | 人不在场,需要它自己跑 |
| 私有知识密度 | 判断藏在你脑子里,写不下来 | 有代码和文档可以被检索 |
读法:左边命中越多,越该用 Copilot;右边命中越多,越该放手给 Agent。但这不是「票数多的赢」——第一行和第二行是一票否决的。 不能自动验证,或者动作不可逆,后面三个变量再漂亮都没用。
决策树:四个问题定下来
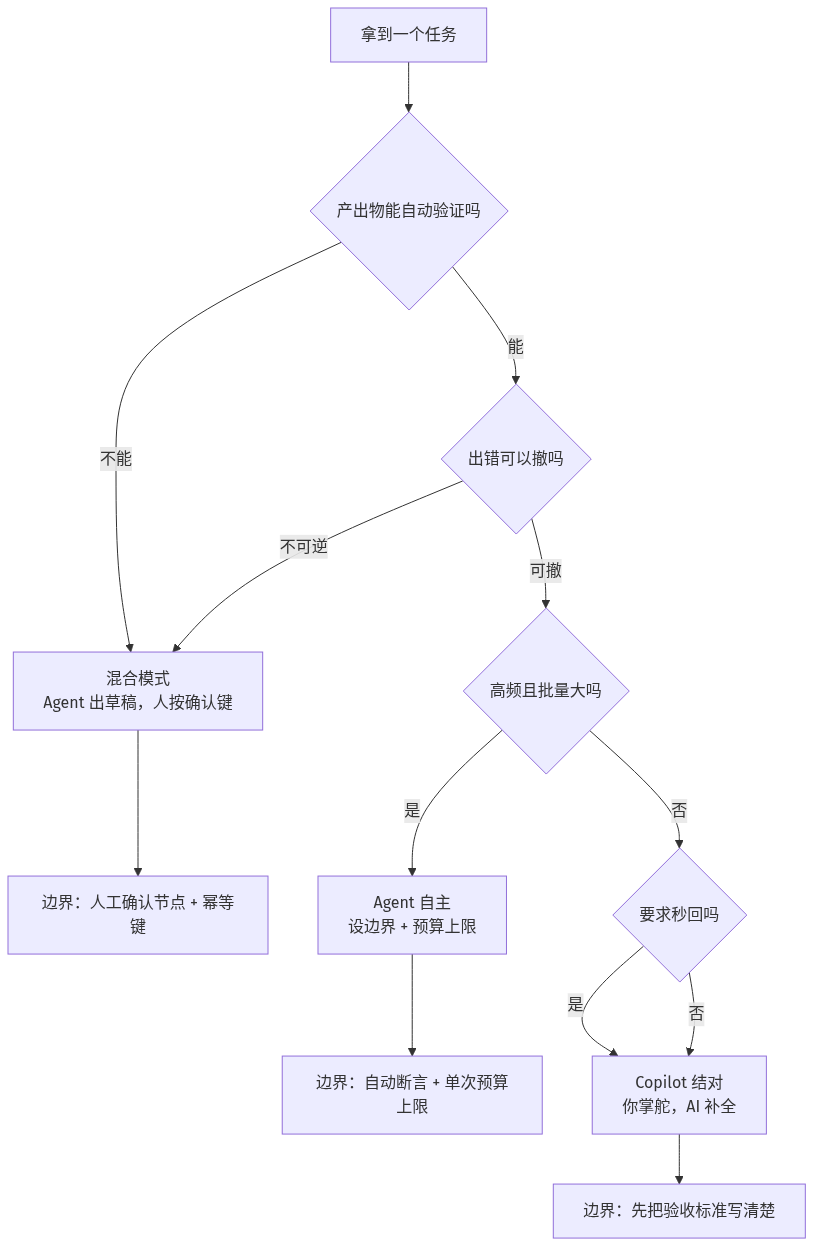
顺序不能乱,因为前两个问题是硬门槛:
- 产出物能自动验证吗? 不能 → 进混合模式,Agent 只出草稿,确认键必须人来按。
- 出错能撤吗? 不可逆 → 同样进混合模式。这一条把「给客户退款」「群发邮件」「删生产库」全部挡在 Agent 自主之外。
- 高频且批量大吗? 是 → Agent 自主,但必须配上自动断言和单次预算上限。
- 要求秒回吗? 是 → 回到 Copilot 或干脆写固定脚本。要求秒回的任务(客服自动回复、搜索建议)本质是「必须在这几百毫秒里出结果」,多轮循环天然跑不赢,别硬上。
三条出口,各自守着一条边界:混合模式守「人工确认 + 幂等键」,Agent 自主守「自动断言 + 预算」,Copilot 守「先把验收标准写清楚」。
实战:一个能跑的分工决策器
光讲道理记不住。把上面那棵树写成代码,下次拿不准的时候跑一下就行。
#!/usr/bin/env python3
"""Agent / Copilot 分工决策器:给任务打六个分,输出主导模式 + 必须守住的边界。

打分范围 0-2。判据只有一条主线:
    任务能不能被机器自动验证 + 出错能不能撤。
两条都成立 → 放手让 Agent 跑;有一条不成立 → 人必须留在环内。
"""

MODES = {
    "agent":   "Agent 自主:你设边界,它掌舵",
    "copilot": "Copilot 结对:你掌舵,它补全",
    "hybrid":  "混合:Agent 出草稿,人按确认键",
}


def decide(task):
    v = task["verify"]       # 0 无标准 / 1 有标准但要人看 / 2 可自动断言
    r = task["reversible"]   # 0 不可逆 / 1 半可逆 / 2 随便重跑
    p = task["present"]      # 0 人不在场 / 1 偶尔看一眼 / 2 全程在场
    k = task["private_ctx"]  # 0 不依赖私有知识 / 1 部分依赖 / 2 全靠私有知识
    f = task["repeat"]       # 0 一次性 / 1 偶尔做 / 2 高频批量
    l = task["latency"]      # 0 必须秒回 / 1 分钟级 / 2 小时级也能接受

    # 判据主线:能自动验证 + 可重跑 + 等得起,才把方向盘交出去
    if l == 0:                                  # 要求秒回,多轮循环天然超标
        mode = "copilot" if v >= 1 else "hybrid"
    elif v == 2 and r >= 1:
        mode = "agent"
    elif v == 0 or r == 0:
        mode = "hybrid"
    else:
        mode = "copilot"

    bounds = []
    if v == 0:
        bounds.append("验收无标准:人会一直是验证器,别让 Agent 一口气跑完")
    if r == 0:
        bounds.append("动作不可逆:Agent 只出草稿,最后一个按钮人来按")
    if p == 0:
        bounds.append("人不在场:必须补自动验收 + 单次预算上限")
    if k == 2:
        bounds.append("全靠私有知识:先接检索,别指望模型记住你的库")
    if f == 0:
        bounds.append("一次性任务:搭 Agent 的工期比手做还长,直接结对")
    if l == 0:
        bounds.append("要求秒回:多轮循环的天然延迟就超标,缓存或固定脚本")
    return MODES[mode], mode, bounds or ["边界清晰,可以直接放手跑"]


TASKS = [
    ("给一个 300 行的老函数补 pytest 用例",
     dict(verify=2, reversible=2, present=2, private_ctx=1, repeat=1, latency=1)),
    ("写一段还在改需求的结算逻辑",
     dict(verify=1, reversible=2, present=2, private_ctx=2, repeat=0, latency=1)),
    ("把 40 个文件从 requests 批量迁到 httpx",
     dict(verify=2, reversible=2, present=0, private_ctx=1, repeat=2, latency=2)),
    ("给客户发退款并回复工单",
     dict(verify=1, reversible=0, present=0, private_ctx=2, repeat=2, latency=2)),
    ("生成季度复盘 PPT 初稿",
     dict(verify=0, reversible=2, present=2, private_ctx=2, repeat=0, latency=2)),
    ("帮用户查订单状态并回消息",
     dict(verify=2, reversible=2, present=0, private_ctx=1, repeat=2, latency=0)),
]

if __name__ == "__main__":
    for name, task in TASKS:
        mode_name, key, bounds = decide(task)
        print(f"任务:{name}")
        print(f"  主导:{mode_name}")
        for b in bounds:
            print(f"  边界:{b}")
        print()
拿六个真实场景跑一遍,下面是真跑出来的输出:
任务:给一个 300 行的老函数补 pytest 用例
  主导:Agent 自主:你设边界,它掌舵
  边界:边界清晰,可以直接放手跑

任务:写一段还在改需求的结算逻辑
  主导:Copilot 结对:你掌舵,它补全
  边界:全靠私有知识:先接检索,别指望模型记住你的库
  边界:一次性任务:搭 Agent 的工期比手做还长,直接结对

任务:把 40 个文件从 requests 批量迁到 httpx
  主导:Agent 自主:你设边界,它掌舵
  边界:人不在场:必须补自动验收 + 单次预算上限

任务:给客户发退款并回复工单
  主导:混合:Agent 出草稿,人按确认键
  边界:动作不可逆:Agent 只出草稿,最后一个按钮人来按
  边界:人不在场:必须补自动验收 + 单次预算上限
  边界:全靠私有知识:先接检索,别指望模型记住你的库

任务:生成季度复盘 PPT 初稿
  主导:混合:Agent 出草稿,人按确认键
  边界:验收无标准:人会一直是验证器,别让 Agent 一口气跑完
  边界:全靠私有知识:先接检索,别指望模型记住你的库
  边界:一次性任务:搭 Agent 的工期比手做还长,直接结对

任务:帮用户查订单状态并回消息
  主导:Copilot 结对:你掌舵,它补全
  边界:人不在场:必须补自动验收 + 单次预算上限
  边界:要求秒回:多轮循环的天然延迟就超标,缓存或固定脚本
三处输出值得展开。
一、「给客户退款」被判成混合模式,不是因为难,是因为不可逆。 这个任务的技术难度可能是整张清单里最低的:查订单、调支付 API、发条消息。但它也是唯一会造成真金白银损失的动作。Agent 完全可以把它做成一份草稿加一个待确认按钮,但绝不能拿到那个「按下去」的权限。不可逆性比复杂度更能决定一个任务能不能交给 Agent。
二、「批量迁移 40 个文件」这种又脏又长的活儿,反而是 Agent 的主场。 人不在场、批量大、验证靠编译器和测试,三个条件全中。这类任务人做起来最痛苦(重复、无聊、容易漏掉第 37 个文件),Agent 做起来最稳(不会累、不会跳)。最好的 Agent 用例,往往正是最不值得人亲手做的那些。
三、「查订单状态回消息」被判给了 Copilot,理由是延迟。 这条最容易踩坑。它明明能自动验证,也高频,看上去天生适合 Agent;但它要求秒回,而 Agent 要经过规划、调工具、验证、再规划,几秒起步。正解是用固定脚本查订单、模板化回复——也就是 03 篇那句「能用脚本解决的,不要用 Agent 解决」。在秒回任务上,Agent 的自主性是纯粹的负债。
三个反直觉的结论
一、Copilot 不是「弱化版的 Agent」。 它有一个 Agent 给不了的东西:你的在场。你在逐行判断的过程中会长出对代码的品味——知道哪种抽象是好的、哪条边界该留在哪里。这份品味,正是你后面能写出合格验收标准的前提。一上手就把活全甩给 Agent 的人,半年后往往还是写不出一份能自动跑的验收标准。
二、Agent 的门槛不在模型,在验收。 写不出验收标准,就等于没有自动验证器,就只剩人眼一条路;而人眼一次只能盯住一件事。所以「Agent 能不能规模化」的真实上限,是你把验收自动化的能力——不是模型多大,是你的断言写得多细。
三、真实工作里几乎不存在纯 Agent 或纯 Copilot。 一个功能通常长这样:核心判断逻辑用 Copilot 结对写(因为需求还在变)、周边机械改造批量交给 Agent、上线前让 Agent 跑测试而人只看红绿。会分工,比选边站重要得多。
顺带一句:这篇讲的是「模式怎么选」。如果你卡住的是「产品怎么选」——Claude Code、Cursor、Copilot 到底买哪个——那是我在 Claude Code vs Cursor vs Copilot 横评 里回答的问题。两层决策,先定模式,再看产品。
记住这一件事
一句话:Agent 和 Copilot 不是对手,是同一套工作流里的两个档位。 挂哪个档,只看两件事——产出物能不能被机器自动验证,出错了能不能撤。两条都成立,把方向盘交出去;缺一条,就让人留在环里,把 Agent 缩成一个「只出草稿的实习生」。
下一篇往技术方向再下潜一层,聊 Agent 内部的骨架:ReAct、Plan-Execute、Multi-Agent 三种架构模式——同样是「思考—行动—观察」,它们把这套循环组装成了三台完全不同的机器。
AI Agent 全解析系列:
1. AI Agent 是什么——从 LLM 到自主智能体的进化
2. Agent 的四大核心能力:规划、记忆、工具、执行
3. 2026 AI Agent 全景图:谁在做什么,谁能用
4. 👉 选 Agent 还是选 Copilot?不同场景的决策框架(本文)
5. Agent 的架构模式:ReAct、Plan-Execute、Multi-Agent(下一篇)
💬 Comments