AI Agent 全解析:2026 AI Agent 全景图——谁在做什么,谁能用
前两篇讲了一个 Agent,这篇讲一整个市场
01 篇(AI Agent 是什么——从 LLM 到自主智能体的进化)把 Agent 拆成了「思考—行动—观察」的循环;02 篇(Agent 的四大核心能力:规划、记忆、工具、执行)补上血肉,讲清规划、记忆、工具、执行各管一段。两篇都在低头看零件。
这篇换个姿势,抬头看全局。因为你一旦动手,第一个问题从来不是「怎么实现」,而是「市面上已经有谁做完了,我要不要直接用」。
麻烦在于,2026 年的 Agent 市场噪音大过信号。每一家都说自己是 Agent,PPT 上都写着自主、多步、端到端。但把这些产品按「真的能跑」重排一遍,它们非常干净地落成了四层。而且层次之间分的不是聪明程度,是——它干完活之后,谁来检查它干得对不对。
全景图:四个梯队
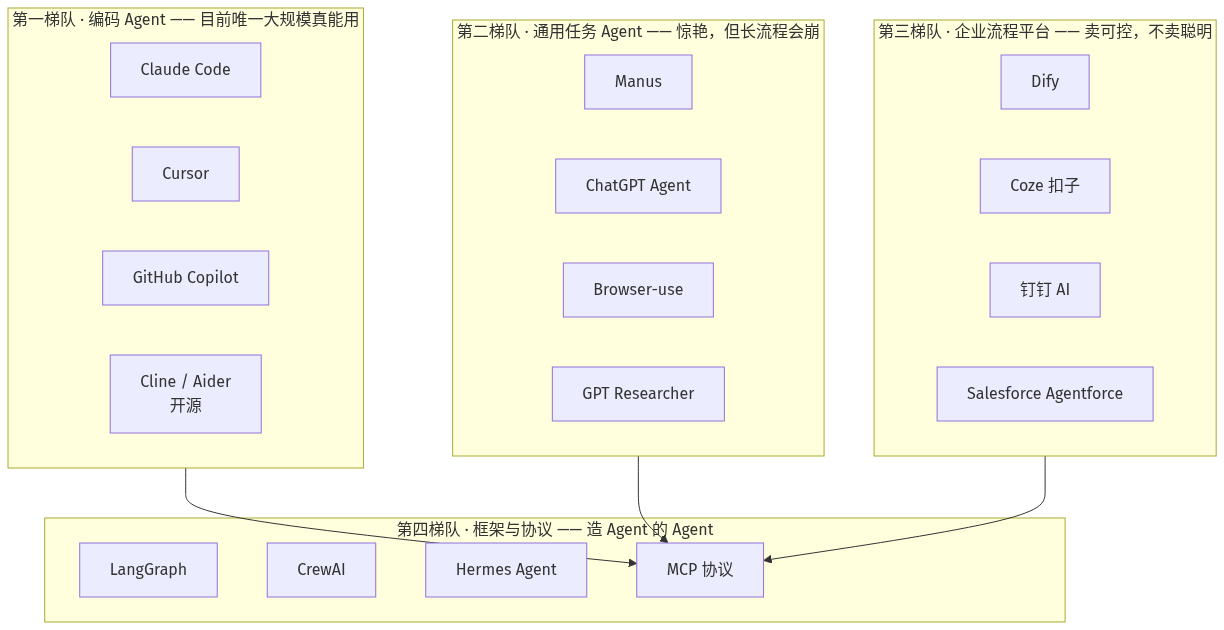
先说分层的依据。我不用「技术先进度」,那东西六个月就翻篇。我用的是一条更稳定的线:这个 Agent 交付之后,验证责任落在谁头上。
- 第一梯队 · 编码 Agent:编译器帮你检查。
- 第二梯队 · 通用任务 Agent:你自己看着截图检查。
- 第三梯队 · 企业流程平台:流程和审批人帮你检查。
- 第四梯队 · 框架与协议:不干具体的活,负责让上面三层能被造出来。
第一梯队:编码 Agent,目前唯一大规模真能用的
代表:Claude Code、Cursor、GitHub Copilot;开源那一侧是 Cline 和 Aider。
它们能跑起来,不是因为模型更聪明,而是因为软件开发这个场景天生自带验证器:代码能编译、测试能跑、git diff 能看、出了事能 revert。Agent 一旦走偏,三步之内必然有一个红色的报错把它拦下来,而那个报错本身就是下一轮思考最好的输入。
这正是 02 篇讲的「观察」在起作用——在编码场景里,观察拿到了最干净的信号。换成别的场景立刻就没有了:让 Agent 写一份周报,谁告诉它写偏了?没人,只有你。
所以我自己的效率排序很明确:编码 Agent 的投入产出比,比其余所有 Agent 加起来还高一个量级。 如果你 2026 年只想认真用一件 AI 工具来提高收入,就是它。
第二梯队:通用任务 Agent,惊艳但长流程会崩
代表:Manus、ChatGPT Agent、开源的 Browser-use,以及做资料研究的 GPT Researcher。
这是最会做演示的一层。三分钟的视频里,它开浏览器、填表单、比价、生成报告,看得人头皮发麻。但真实使用中,它们栽的地方高度一致:第 3 步到第 6 步之间。
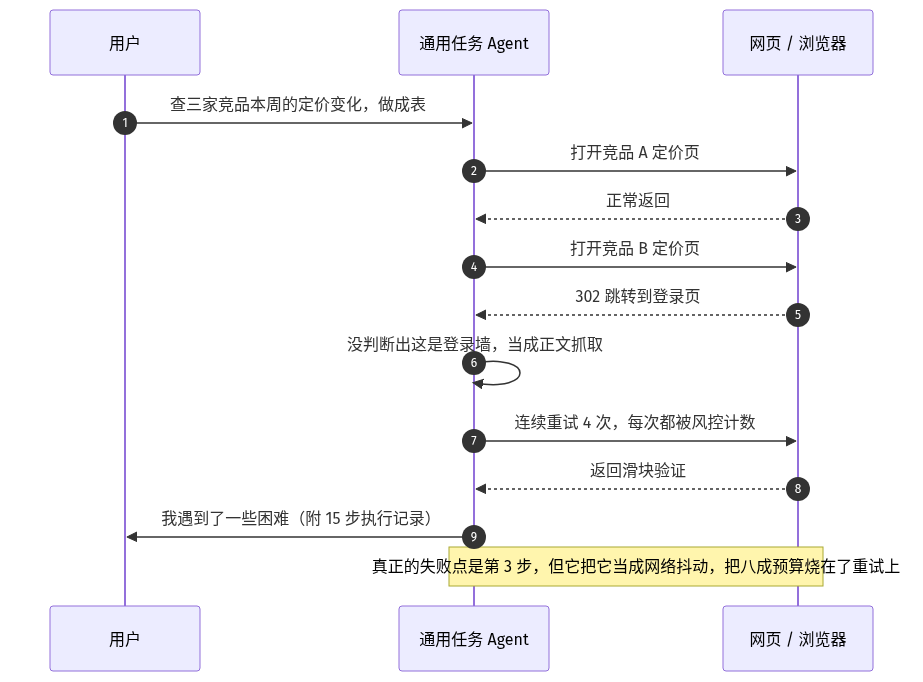
上图这次失败非常典型。任务是一句很普通的话:「查三家竞品本周的定价变化,做成表」。Agent 打开第一家,正常;打开第二家,被 302 跳到登录页;它没识别出「这是登录墙」,把它当成了「网络抖动」,于是连续重试四次,触发风控,然后拿着烧掉八成的预算来找你求助。
它不是不聪明。它是没有能力区分「暂时失败」和「这件事我根本做不了」。前者该退避重试,后者该立刻停下来问你。这个判断在编码场景里由编译器代劳,在开放网络里没有替身。
所以这一层现在的正确用法是:把它当探索器,不当执行器。 用它去找、去试、去生成原型,但最后那个动作由人落地。它适合的任务有个共同特征——失败了不心疼,可以随便重跑。
第三梯队:企业流程平台,卖的是可控不是聪明
代表:Dify、Coze(扣子)、钉钉 AI,海外的 Salesforce Agentforce。
这一层的模型能力往往不如前两层,但企业客户反而更认它。原因很简单:企业买的不是「更会干活的 AI」,是「出事有人兜底的 AI」。
一个人用的 Agent 挂了,重跑一次就行;一个嵌在报销流程里的 Agent 乱发了一笔钱,那是事故。所以这一层真正在卖的是:权限边界、操作留痕、人工审批节点,以及和既有系统(钉钉、飞书、CRM)的对接。这些一点都不酷,但它们决定了一个 Agent 能不能进公司内网。
如果你在做 to B 的产品,这一层是机会——不是因为技术门槛高,而是因为这一层的核心工作量在集成和合规上,不在模型上。 模型换代不会把这些工作抹掉。
第四梯队:框架与协议,造 Agent 的 Agent
代表:LangGraph、CrewAI、Hermes Agent,以及正在变成事实标准的 MCP 协议。
上面三层是成品,这一层是零件和标准。前三层能存在,是因为这一层把「怎么循环、怎么调工具、怎么存记忆」这些脏活固化成了可复用的东西。
选这一层的信号只有一个:你要做的事市面上没有现成产品,或者你不想把核心流程交给别人的 API。 代价是你得自己扛执行层的容错——这也是为什么 02 篇我把最多篇幅给了执行:自己做 Agent,八成时间会花在那儿。
一句提醒:别为了「想学 Agent」而选第四梯队。想学,先用第一梯队的产品把日常活儿提效,收益立刻兑现;真要造,再下来。
为什么会分成这四层:验证成本
回到分层依据。全景图里那三个指向第四层的箭头,说的其实是同一件事:谁负责验证。
- 编码 Agent → 编译器
- 通用任务 Agent → 人的眼睛
- 企业平台 → 审批流和制度
验证成本越低,Agent 能自主跑的步数就越长。这不是巧合。每一轮「思考 → 行动 → 观察」要能继续下去,观察里必须包含「刚才那步对不对」这条信息。 观察里没有它,Agent 就只能靠猜,猜五步之后必然失控——这是 01 篇那个循环唯一的死穴。
这条规律可以直接当尺子用:评估一个 Agent 能不能接你的任务,先问「它每走一步,谁能告诉它对不对」。 答不上来,这个任务现阶段就不该交给 Agent。
选型决策树:三分钟定下来
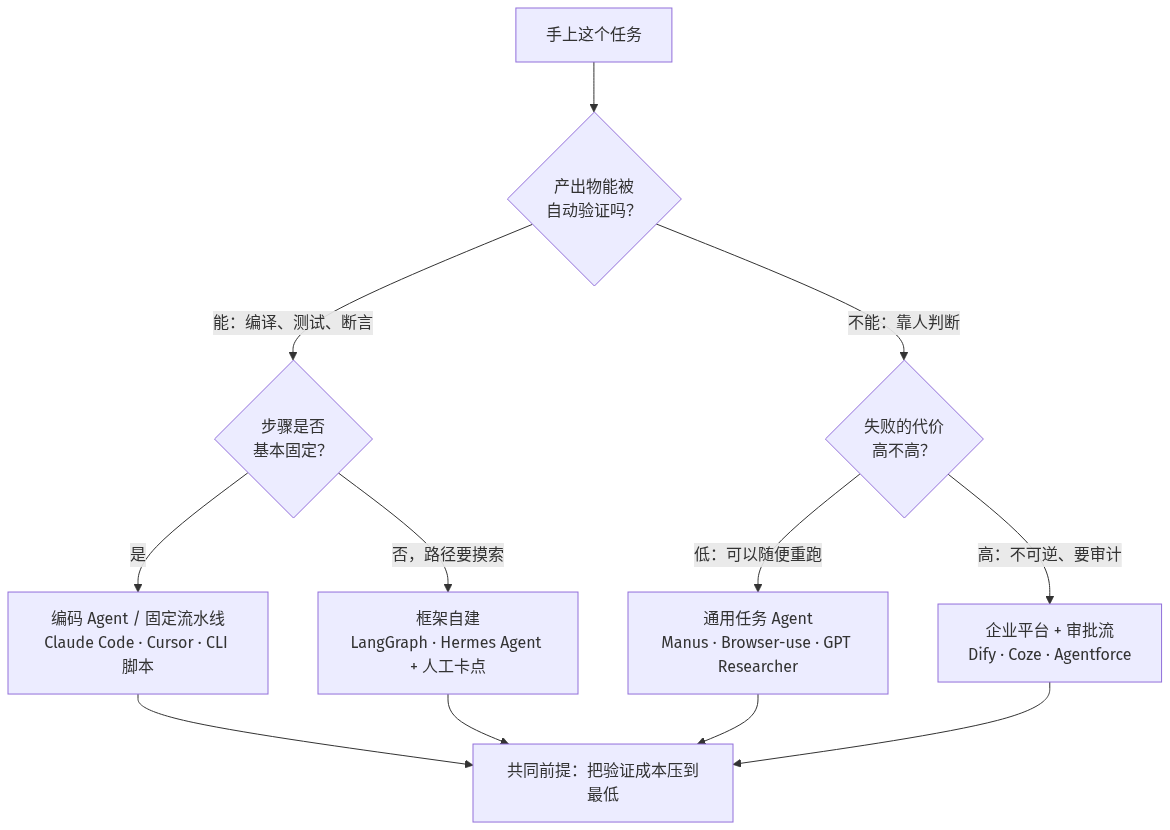
三个问题,从上往下问:
- 产出物能被自动验证吗?(能编译、能跑测试、能断言数字)能,往左;不能、只能靠人判断,往右。
- 左边分支:步骤基本固定吗? 固定 → 编码 Agent,或者干脆写个固定流水线脚本;要边做边摸索 → 上框架自建,加人工卡点。
- 右边分支:失败的代价高吗? 低、可重跑 → 通用任务 Agent;高、不可逆、要审计 → 企业平台加审批流。
不管走哪条路,最后都收敛到同一句话:把验证成本压到最低。 能加断言就加断言,能写测试就写测试,能留人工确认就留一个。这不是「不信任 AI」,恰恰相反——这是让 AI 有机会自己发现自己错了。
实战:一个能跑的选型体检脚本
光讲道理没用。我把上面那棵树写成了三十来行 Python:输入任务特征,输出该用哪一梯队,以及最可能翻车的点。
#!/usr/bin/env python3
"""Agent 选型体检器:把任务特征翻译成「该用哪一梯队 + 最大风险点」。"""

TIERS = {
    "coding":   "编码 Agent / 固定流水线(Claude Code、Cursor、CLI 脚本)",
    "flow":     "框架自建(LangGraph、Hermes Agent)+ 人工卡点",
    "general":  "通用任务 Agent(Manus、Browser-use、GPT Researcher)",
    "platform": "企业平台 + 审批流(Dify、Coze、Agentforce)",
}

def triage(task):
    v = task["verifiable"]     # 0 靠人判断 / 1 有明确标准 / 2 能自动断言
    d = task["deterministic"]  # 0 每次都不一样 / 1 大方向固定 / 2 固定流水线
    e = task["environment"]    # 0 干净 API / 1 网页无登录 / 2 登录·验证码·风控
    r = task["reversible"]     # 0 不可逆 / 1 半可逆 / 2 随便重跑
    c = task["context"]        # 0 小 / 1 中 / 2 大(一次塞不进上下文)

    # 判定顺序,就是决策树从上往下走的那条路
    if r == 0 or c == 2:
        tier = "platform"
    elif v >= 1 and d == 2 and e <= 1:
        tier = "coding"
    elif e == 2 and r >= 1:
        tier = "general"
    else:
        tier = "flow"

    risks = []
    if e == 2:
        risks.append("环境脏:登录态、验证码、风控")
    if v == 0:
        risks.append("验收靠人:必须留人工确认这一步")
    if r == 0:
        risks.append("动作不可逆:幂等键 + 审批流")
    if c == 2:
        risks.append("上下文超预算:先检索再进模型")
    if d == 0:
        risks.append("路径不确定:别写死计划,用 ReAct + 预算上限")
    return TIERS[tier].split("(")[0], risks or ["没有明显红线,可以直接上"]
拿五个真实任务跑一遍(下面的输出是真跑出来的):
任务:给仓库里 200 个文件补类型注解
  判定:编码 Agent / 固定流水线
  风险:没有明显红线,可以直接上

任务:每周一自动汇总 5 个竞品官网动态发邮件
  判定:编码 Agent / 固定流水线
  风险:没有明显红线,可以直接上

任务:从 300 份合同 PDF 里抽取关键条款并入库
  判定:企业平台 + 审批流
  风险:上下文超预算:先检索再进模型

任务:自动给客户退款并回复工单
  判定:企业平台 + 审批流
  风险:动作不可逆:幂等键 + 审批流

任务:在小红书后台批量发布店铺笔记
  判定:通用任务 Agent
  风险:环境脏:登录态、验证码、风控
  风险:验收靠人:必须留人工确认这一步
  风险:路径不确定:别写死计划,用 ReAct + 预算上限
输出里有三处值得多说两句。
第一,「竞品动态汇总」被判成了「固定流水线」,而不是 Agent。 这是这段脚本最有价值的输出。它的步骤固定、产出能被断言(新条目数、链接有效性),那就写个定时脚本发邮件最省事,完全用不上 Agent 的自主性——在固定流程里,自主性只会带来不确定性。能用脚本解决的,不要用 Agent 解决。
第二,合同抽取被判给企业平台,理由不是难度,是上下文。 300 份 PDF 塞不进任何模型的上下文,问题必须在进模型之前解决——这就是第 07 篇要讲的记忆与 RAG。很多人一上手就想着换更大的上下文窗口,那等于花钱买一个错误的解法。
第三,「小红书批量发帖」那一行的风险列表最长。 环境脏、验收靠人、路径不确定,三条全中。这种任务不是不能做,而是你必须先把风险逐条变成工程措施:登录态持久化、发布前人工确认、单次预算上限。三项少一项,这个 Agent 上线就是定时炸弹。
三个反直觉的结论
一、能力最强的梯队,不是用得最多的梯队。 通用任务 Agent 最会做演示,但真正每天帮人干活的,是编码 Agent 和那些不起眼的固定流水线脚本。
二、企业平台技术上最保守,商业上最稳。 因为它们卖的不是模型能力,是可审计、可审批、可集成。这部分价值不会随模型换代而蒸发。
三、大多数「Agent 不好用」的抱怨,本质是选错了层。 拿一个开放环境的脏活儿,去要求编码 Agent 级别的可靠性;或者拿一个固定流程,去上全套 Agent 框架——两边都会得出「Agent 是噱头」的结论。但问题出在选型,不在技术。
记住这一件事
一句话:2026 年 Agent 的成熟度,不取决于模型多聪明,取决于这个任务有多容易被验证。 编码最强,因为编译器免费当裁判;通用任务最飘,因为裁判是你自己;企业平台最稳,因为它把裁判写进了审批流。
下一篇往下走一层,聊一个更具体的选择题:当你面前同时摆着 Agent 和 Copilot 两个选项,「选 Agent 还是选 Copilot」到底该怎么决策。
AI Agent 全解析系列:
1. AI Agent 是什么——从 LLM 到自主智能体的进化
2. Agent 的四大核心能力:规划、记忆、工具、执行
3. 👉 2026 AI Agent 全景图:谁在做什么,谁能用(本文)
4. 选 Agent 还是选 Copilot?不同场景的决策框架(下一篇)
💬 Comments