AI Agent 全解析:Agent 的四大核心能力——规划、记忆、工具、执行
循环是骨架,这四样是血肉
上一篇(AI Agent 是什么——从 LLM 到自主智能体的进化)我们把 Agent 拆成了一个循环:思考 → 行动 → 观察,然后回到思考。骨架就这么点东西,三十行代码就能跑起来。
但我第一次把那个循环丢进真实任务,它撑不过三步。目标一复杂就开始鬼打墙:同一个页面反复抓、抓完转头就忘、工具报错了当没看见继续往下走、三个网页的原文全怼进上下文然后超预算。
问题不在循环,在循环里缺了四样东西。循环只回答「怎么转」,不回答「靠什么转」:
- 规划(Planning):决定先干什么、后干什么。
- 记忆(Memory):知道刚干过什么、上次干到哪。
- 工具(Tools):有手,能对外部世界做动作。
- 执行(Execution):动作真的落地——包括失败了怎么办。
这四块缺一块,坏法完全不一样,而且都是那种「跑得挺欢、结果全错」的坏法:
- 缺规划:重复劳动。抓过的页面再抓一遍,绕远路,一个任务烧掉十倍的 token。
- 缺记忆:每次从零开始。昨天跑过的进度今天归零,用户说过的偏好每一轮都要重说。
- 缺工具:只会说的嘴。写不出文件、发不出邮件,只能给你「建议」。
- 缺执行:PPT 工程。计划写得漂亮,第一步网络超时它就卡死在那儿了。
一张图看清四块的位置
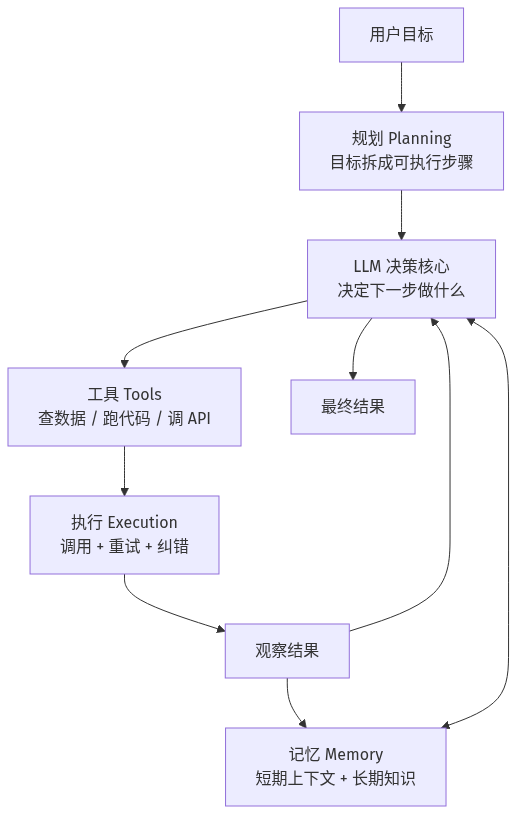
四个能力不是并列的四块砖,它们有明确的层级和职责:
- 规划在最上游:把「一句话目标」翻译成「一串步骤」。这一步错了,后面全在错的路上跑得飞快。
- 记忆横跨全程:既读也写。规划要靠它知道上次干到哪,执行要把结果写回去供明天用。
- 工具决定能力边界:Agent 永远不会比它的工具更强。它能查数据库,是因为你给了它查数据库的手;它不能改合同,是因为你没给,不是因为它不会。
- 执行是最后一公里:决定「想到了」能不能变成「做到了」。这一层最不性感,但线上事故八成出在这儿。
有个好用的判断法:任何一个 Agent 项目出问题,你都能把它归到这四块里的某一块。「它老抓重复页面」→ 记忆;「它把任务顺序搞反」→ 规划;「它学会了调接口但拿不到数据」→ 执行。定位准了,修起来就是十分钟的事。
规划:把一句话目标,拆成一串能验证的步骤
先说清楚一件事:规划有两种做法,别混着用。
隐式规划就是上一篇的 ReAct——不预先列计划,每一步都由模型看着当前状态决定下一步。灵活,适合探索型任务(查资料、debug)。缺点是容易原地打转,因为没有「全局清单」提醒它还剩什么没干。
显式规划是先让模型产出一份步骤清单,再按清单逐条执行(Plan-and-Execute)。适合步骤基本确定的流水线,比如「抓三个源 → 去重 → 摘要 → 发送」。它最大的好处不是更聪明,而是清单本身就在上下文里,模型没法假装忘记了。
我的默认选择是显式规划 + 局部 ReAct:大框架用清单钉死,清单里每一步怎么完成,允许模型自己绕。就像装修——工序表定死(水电、瓦工、木工),但每道工序里师傅怎么下手,不用你管。
写规划层,我盯三个指标:
- 粒度:一步一件事,且一步的产出可以被验证。「优化用户体验」不是一步,「抓取 a.com 的 changelog 页面并抽正文」才是。
- 显式:清单要以结构化数据存在代码里(下面代码里的
todo列表),不是写在 prompt 里的一段自然语言。写到代码里才能做重试、跳过、断点续跑。 - 可改:允许模型在执行中提「第 4 步应该插一步」,但改计划本身要留下记录,并且重新规划的成本要算进预算,否则模型会一轮一轮地改规划,永远不开始干。
规划层的代码简单得让人失望——真正难的是上面那三个指标,不是代码:
def plan(goal, mem, sources):
    """显式规划:先把目标拆成带序号的步骤,再逐步执行。"""
    todo = []
    for i, url in enumerate(sources, 1):
        todo.append({"id": i, "kind": "fetch", "url": url})
    todo.append({"id": len(todo) + 1, "kind": "summarize"})
    todo.append({"id": len(todo) + 1, "kind": "send"})
    return todo
记忆:不是把所有历史都塞进上下文
新手对记忆的直觉是「把对话历史全留着」。这个直觉在小 demo 里没错,到了真实场景立刻破产:一个网页正文动辄三五千 token,抓十个就是五万 token,还没开始思考,上下文已经满了。而且塞得越多,模型注意力越散,关键信息被淹掉。
正确的做法是把记忆分成两层,各管一段:
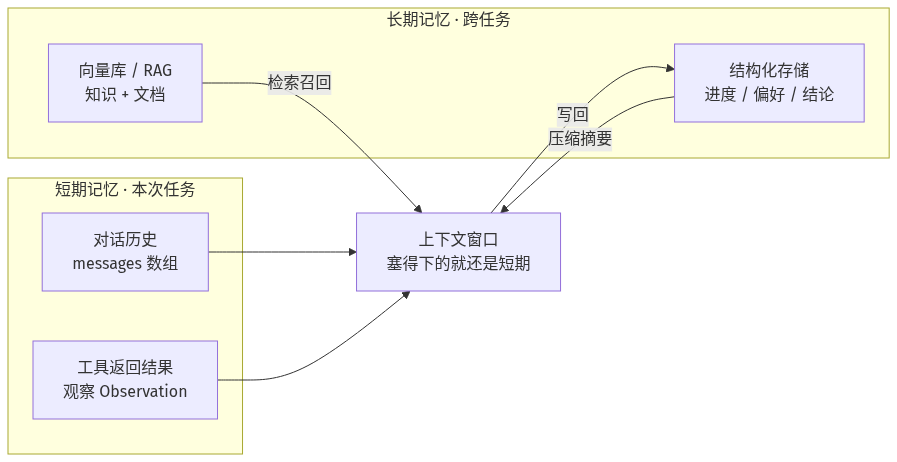
- 短期记忆:就是上下文窗口里的那些消息——对话历史、工具返回的观察结果。它快、直接,但容量有限,必须做滑动窗口 + 摘要压缩:只留最近几轮完整内容,更早的压成一句「已压缩 N 条」。
- 长期记忆:落盘的、跨任务存在的。分两类——一是结构化状态(跑到哪一步了、哪些 URL 已经处理过、用户稳定偏好),用 JSON/SQLite 存就够,读取靠键值查询;二是非结构化知识(文档、历史结论),走向量库 + RAG 检索召回。
判断一样东西该不该进长期记忆,我问三个问题:下次运行还需要它吗?它会改变下一步决策吗?丢了要付出代价吗?三个都「是」才存。工具返回的原始 HTML 就不该存——存它处理完的结论。
两层记忆的代码,一层一个函数,很短:
def load_memory():
    """长期记忆:结构化落盘,跨天不丢。"""
    if os.path.exists(MEM_FILE):
        return json.load(open(MEM_FILE))
    return {"seen_urls": [], "last_summary": None}

def save_memory(mem):
    json.dump(mem, open(MEM_FILE, "w"), ensure_ascii=False)

def trim(messages, keep=6):
    """短期记忆:滑动窗口 + 摘要压缩,别让工具返回把上下文撑爆。"""
    if len(messages) <= keep:
        return messages
    head, tail = messages[:1], messages[-(keep - 2):]
    dropped = len(messages) - len(head) - len(tail)
    summary = {"role": "system", "content": f"[已压缩 {dropped} 条更早的观察记录]"}
    return head + [summary] + tail
工具:能力边界,也是翻车重灾区
工具不只是「一个能被调用的函数」,它是三件东西的打包:
- 名字:模型靠它选择调用。用动词 + 名词,
fetch_page比process强一百倍。 - 描述:这是决定调用准确率的第一因素,比模型选得好不好重要得多。描述里要写清「干什么、什么时候用、参数什么格式、有什么副作用」。
- 参数 schema:类型和必填项。这是你的第一道防线,别指望模型永远给对参数。
举个我踩过的坑。同一个函数,两种描述:
# 描述 A —— 模型经常漏传 url,或者传个「a.com」这种没有协议头的字符串
"fetch_page": {"fn": fetch_page}

# 描述 B —— 调用成功率肉眼可见地涨
"fetch_page": {
    "desc": "抓取一个网页并返回标题和正文。参数 url 必须是完整地址(含 https://)。",
    "args": {"url": "str"},
    "fn": fetch_page,
}
工具层还有一个反直觉的设计原则:工具失败时不要抛异常,要把它当成「观察结果」返回给模型。原因是——模型看到「缺参数 url」这条错误,下一轮会自己补上参数重试;而你抛出去一个 Python 异常,整个 Agent 就死了,什么都没学到。
下面这个 call_tool 是全文我最想让你抄的一段:
def call_tool(name, args):
    """统一入口:先校验参数,再把错误当作「观察结果」返回给模型,而不是抛异常。"""
    if name not in TOOLS:
        return {"ok": False, "error": f"没有这个工具:{name}"}
    spec = TOOLS[name]
    missing = [k for k in spec["args"] if k not in args]
    if missing:
        return {"ok": False, "error": f"缺参数 {missing},请补齐后重试"}
    try:
        return {"ok": True, "data": spec["fn"](**args)}
    except Exception as e:
        return {"ok": False, "error": f"{type(e).__name__}: {e}"}
执行:从「想到」到「做到」的最后一公里
「执行」听起来像一句废话——工具都定义好了,调用它不就完了?不是。调用是执行里最不重要的一步。真正让 Agent 从玩具变成能用的东西的,是调用前后的四件事:
- 超时:必须给每个外部调用设上限。没超时的 Agent 会在某个卡死的请求上永远等下去。
- 重试:网络抖动是常态。带退避的重试(1 次、2 次、4 次)能救回大部分临时失败,但只对可重试的错(超时、5xx)重试,参数错误重试一万次也没用。
- 幂等:这是重试的前提。发邮件、下单、写数据库这些有副作用的动作,必须带幂等键,否则重试一次就给用户发两封邮件。
- 权限:删文件、转账、对外发布这类不可逆动作,要么关掉,要么强制人工确认。Agent 不会为后果负责,负责的是你。
把四件事塞进一个 execute 函数,代码长这样:
def execute(step, attempts=3, backoff=1.0):
    """执行不是「调用一下」:要超时兜底、重试、幂等。"""
    idem = hashlib.md5(json.dumps(step, sort_keys=True).encode()).hexdigest()[:8]
    print(f"  [执行] step#{step['id']} 幂等键={idem}")
    for n in range(1, attempts + 1):
        if step["kind"] == "fetch":
            r = call_tool("fetch_page", {"url": step["url"]})
        elif step["kind"] == "summarize":
            r = call_tool("summarize", {"texts": step["texts"]})
        else:
            r = call_tool("send_email", {"to": step["to"], "body": step["body"]})
        if r["ok"]:
            return r["data"]
        print(f"    失败({n}/{attempts}):{r['error']}")
        if n < attempts:
            time.sleep(0.01 * backoff * n)   # 真实项目里是指数退避
    return {"ok": False, "error": r["error"]}
实战:四块合体,一个竞品日报 Agent
需求一句话:每天 9 点,汇总三个竞品官网的新动态,发到我邮箱。这个任务小到能一次讲完,却把四块能力全用上了。先看一次运行的时序——每一步是哪个能力在干活:
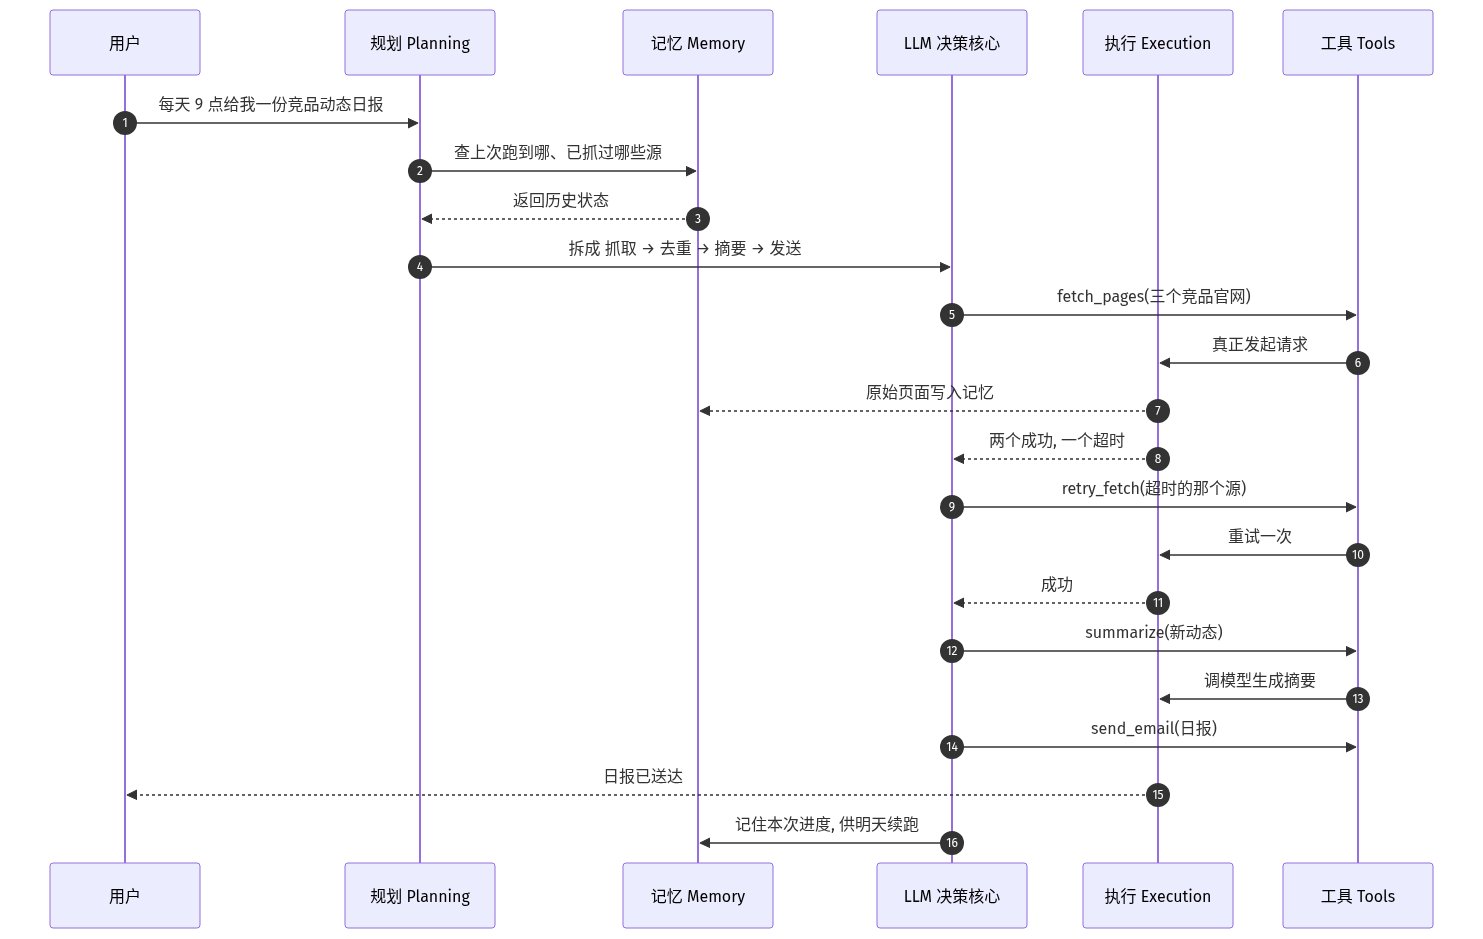
主循环把所有部件串起来,注意每一步的注释:
if __name__ == "__main__":
    if os.path.exists(MEM_FILE):
        os.remove(MEM_FILE)
    mem = load_memory()
    sources = ["https://a.com/changelog", "https://b.com/timeout", "https://c.com/blog"]
    goal = "每天 9 点,汇总三个竞品官网的新动态发我邮箱"
    messages = [{"role": "user", "content": f"目标:{goal}"}]

    todo = plan(goal, mem, sources)
    print(f"[规划] {len(todo)} 步:{[s['kind'] for s in todo]}")

    collected = []
    for step in todo:
        if step["kind"] == "fetch":
            data = execute(step)
            if "url" in data:
                seen = data["url"] in mem["seen_urls"]
                print(f"  [记忆] {'已见过,跳过' if seen else '新页面,收下'} {data['url']}")
                if not seen:
                    collected.append(data["body"])
                    mem["seen_urls"].append(data["url"])
        elif step["kind"] == "summarize" and collected:
            step["texts"] = collected
            mem["last_summary"] = execute(step)
            print(f"  [记忆] 摘要落盘:{mem['last_summary']}")
        elif step["kind"] == "send":
            step.update(to="me@zhouyang.dev", body=mem["last_summary"] or "无新动态")
            print(f"  [执行] 发送结果:{execute(step)}")
跑起来是这样(我用假 HTTP 模拟其中第三个源会超时,输出可复现):
[规划] 5 步:['fetch', 'fetch', 'fetch', 'summarize', 'send']
  [执行] step#1 幂等键=eb55093b
  [记忆] 新页面,收下 https://a.com/changelog
  [执行] step#2 幂等键=0c1a51a6
    失败(1/3):TimeoutError: 请求超时:https://b.com/timeout
    失败(2/3):TimeoutError: 请求超时:https://b.com/timeout
    失败(3/3):TimeoutError: 请求超时:https://b.com/timeout
  [执行] step#3 幂等键=0e4a7b54
  [记忆] 新页面,收下 https://c.com/blog
  [执行] step#4 幂等键=ec77486a
  [记忆] 摘要落盘:本周上线了批量导出功能;本周上线了批量导出功能
  [执行] step#5 幂等键=8e70fd45
  [执行] 发送结果:{'sent': True, 'to': 'me@zhouyang.dev', 'bytes': 23}
[记忆] trim 前 10 条 → trim 后 6 条
[长期记忆] 已记住 2 个源。明天再跑一次:
  跳过(记忆命中)https://a.com/changelog
  跳过(记忆命中)https://c.com/blog
这段输出里藏着四块能力各自的价值,一个个看:
[规划] 5 步:['fetch', 'fetch', 'fetch', 'summarize', 'send']—— 抽象的「汇总动态」变成了五件可执行、可验证的事。b.com那个源连续失败三次、打印了两行失败日志,但整个任务没有崩,后面两步照常完成——这就是执行层的容错。trim 前 10 条 → trim 后 6 条:短期记忆在自动瘦身,跑得越久这个差值越重要。- 最后两行是长期记忆的效果:明天再跑,已经抓过的源直接跳过。没有这一步,Agent 每天都要把整个流程从头啃一遍,还得再花一遍 token 判断哪些是「新」动态。
补偿逻辑也就几行:
    save_memory(mem)
    messages += [{"role": "tool", "content": json.dumps(mem)} for _ in range(9)]
    print(f"[记忆] trim 前 {len(messages)} 条 → trim 后 {len(trim(messages))} 条")

    # 第二次运行:长期记忆生效,已抓过的源不再重复抓
    mem2 = load_memory()
    print(f"[长期记忆] 已记住 {len(mem2['seen_urls'])} 个源。明天再跑一次:")
    for step in plan(goal, mem2, sources):
        if step["kind"] == "fetch" and step["url"] in mem2["seen_urls"]:
            print(f"  跳过(记忆命中){step['url']}")
四能力自检表
拿你手里那个 Agent(或者你想做的那个)对着这张表过一遍,哪一行心虚,那就是你的下一个活儿:
| 能力 | 不合格的样子 | 合格的样子 |
|---|---|---|
| 规划 | 目标直接丢给模型,走一步算一步 | 结构化步骤清单,可跳过、可重试、可断点续跑 |
| 记忆 | 历史全留,上下文撑爆;每次从零开始 | 短期滑动窗口 + 摘要;长期状态落盘,跨天续跑 |
| 工具 | 描述含糊、抛异常、参数不校验 | 名字是动词、描述写清副作用、错误当观察结果返回 |
| 执行 | 一次调用就完事,失败即终止 | 超时 + 退避重试 + 幂等键 + 不可逆动作人工兜底 |
顺带说一句:这四块里,投入产出比最高的是执行层。大部分「Agent 不好用」的抱怨,本质是它一遇到网络抖动就挂了。加个重试比你换一个更贵的模型见效快得多。
三个常见误区
误区一:记忆 = 把所有历史都塞进上下文。结果 token 账单爆炸,模型还因为噪声太多而抓不住重点。记忆的本质是筛选和压缩,不是囤积。记住「上次抓到第 3 个源」比记住整个第三个网页有用得多。
误区二:规划 = 让模型先写一份超长计划。有人让模型一次列 30 步,然后严格执行。问题是真实世界里第 2 步的结果常常会让第 8 步失去意义,而模型还在傻傻地跑第 8 步。计划的价值在于锚定方向,不在于逐字执行——留出重新规划的接口,比一开始规划得多细更重要。
误区三:工具越多越好。工具从 5 个涨到 30 个,调用准确率会掉,因为模型要在更多选项里做选择,而且描述之间开始语义打架。我的经验是单个 Agent 的工具控制在 10 个以内,多的按场景分组,甚至拆成多个专职 Agent 各管一摊——这也是后面讲 Multi-Agent 的伏笔。
记住这一件事
这篇要记住的就一句话:循环是骨架,规划、记忆、工具、执行是血肉。任何一个 Agent 出了毛病,先别急着换模型,把它归到这四块里的某一块,你会发现八成是记忆没筛选、执行没兜底这种「工程问题」,而不是「模型不够聪明」。
下一篇我们抬头看全局:2026 年 AI Agent 的版图——谁在做什么,谁能真用,谁只是 PPT。
AI Agent 全解析系列:
1. AI Agent 是什么——从 LLM 到自主智能体的进化
2. 👉 Agent 的四大核心能力:规划、记忆、工具、执行(本文)
3. 2026 AI Agent 全景图:谁在做什么,谁能用
💬 Comments