AI Agent 全解析:Agent 的记忆系统——短期记忆、长期记忆与 RAG
模型没有记忆,只有一张桌子
上一篇(工具调用深度解析)结尾留了个坑:模型怎么在多次工具调用之间,记住已经发生了什么。这篇填坑,但要先拆掉一个更根本的误解。
大模型没有记忆。每次请求,它看到的只有你这一次塞进去的那段文本。上下文窗口不是硬盘,是一张桌子——面积固定,价格按次收,用完就得收走,下一轮重新摆。所谓「Agent 记住了」,全部是你在这张桌子上摆了什么,以及桌子外面到底存了什么。
于是记忆系统只剩下三个真问题:这一轮要不要留?留在哪?下次怎么找回来? 大多数项目只回答了第三个——装个向量库,把聊天记录全灌进去。结果检索很准,塞进上下文的却是废话,还把真正该用的那段挤没了。
三层,各管各的
图 1 是我现在默认的骨架。注意箭头方向:写和读是两条独立的路,不是一个「存储」能概括的。
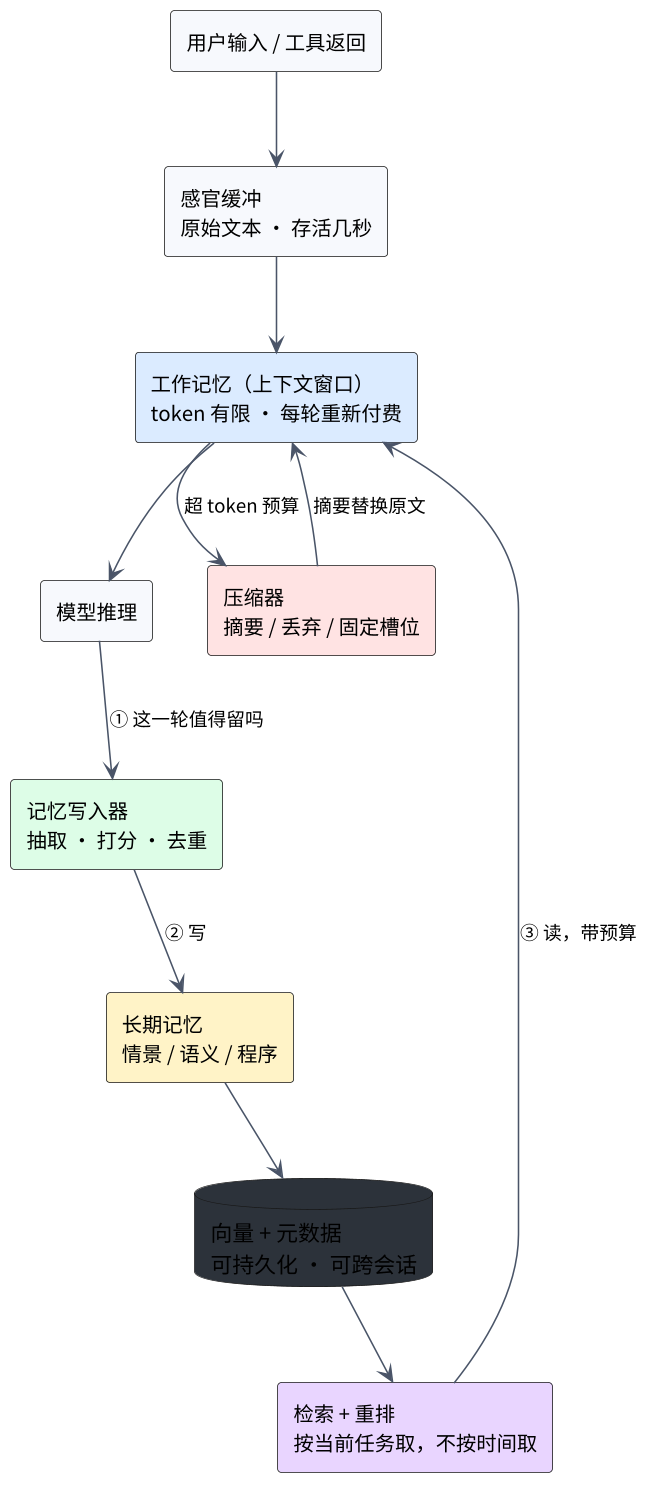
三层职责完全不同,混在一起就会互相拖累:
| 层 | 存什么 | 容量 | 谁负责丢 |
|---|---|---|---|
| 感官缓冲 | 原始输入,未加工 | 秒级 | 自动过期 |
| 工作记忆 | 当前任务的对话、工具结果、检索片段 | token 预算(几千到几十万) | 压缩 / 丢弃 |
| 长期记忆 | 跨会话的事实、偏好、经验 | 几乎无限 | TTL、重要度衰减、合规删除 |
长期记忆再分三类。分法来自认知心理学,工程上却极好用——它决定「写入时抽什么」:
- 情景记忆:发生过什么。「上周三部署挂了,是时区问题。」带时间、带因果。
- 语义记忆:稳定的事实与偏好。「写定价文章先给数字。」不带时间,带适用条件。
- 程序记忆:怎么做一件事。「发版先跑 migration 再切流量。」本质是可复用的操作序列——很多团队干脆把它写成工具或 Skill,而不是记忆。
分不清的代价很具体:偏好当情景存,系统按时间排序,用户三个月前说的「别用 emoji」会被更新的闲聊压下去;情景当语义存,系统会以为「上周那个 bug」永远成立。
写入:九成的系统烂在这一步
先说结论:不该记的记下来,比记不住更糟。 无关记忆会占预算、污染检索,还会在摘要里挤掉重要事实。
所以写入要过三道闸:值不值得记(规则或小模型打分)→ 是不是已经有了(去重)→ 归到哪一类、多重要。下面这段是完整实现的第一块:
WRITE_RULES = [
    (r"偏好|喜欢|习惯|以后", "semantic", 0.90),
    (r"决定|定了|采用|选定|方案是", "semantic", 0.85),
    (r"我们公司|我的项目|我叫|部署在", "semantic", 0.75),
    (r"报错|修好|发布|完成|失败|反馈", "episodic", 0.55),
]

def should_write(text):
    """返回 (kind, importance),None 表示不值得进长期记忆。"""
    for pat, kind, imp in WRITE_RULES:
        if re.search(pat, text):
            return kind, imp
    return None


class LongTerm:
    def __init__(self):
        self.items = []

    def write(self, text, day, source="chat", force_imp=None):
        hit = should_write(text)
        if hit is None and force_imp is None:
            print(f"  [跳过] 无长期价值,不入库:{text[:24]}")
            return None
        kind, imp = hit if hit else ("episodic", force_imp)
        if force_imp is not None:
            imp = force_imp
        vec = to_vec(text)
        for m in self.items:                       # 去重:近似重复只提升权重
            if cos(vec, m.vec) > DEDUP:
                m.importance = min(1.0, m.importance + 0.1)
                m.day = max(m.day, day)
                print(f"  [合并] 与 <{m.text[:14]}…> 重复 → 重要度 {m.importance:.2f}")
                return m
        m = Memory(text, kind, imp, day, source)
        self.items.append(m)
        print(f"  [写入] {kind:<8} imp={imp:.2f} {text[:26]}")
        return m
跑六句话进去,真实输出是这样:
=== A. 写入策略:不是每句话都值得记 ===
  [写入] semantic imp=0.90 以后写定价文章,先把数字摆出来,再讲道理。
  [跳过] 无长期价值,不入库:今天天气不错,先喝杯咖啡。
  [写入] semantic imp=0.85 我们决定这个项目用 SQLite,不上 Postgr
  [写入] episodic imp=0.55 报错修好了,是时区问题。
  [写入] semantic imp=0.90 我喜欢用表格对比方案。
  [合并] 与 <以后写定价文章,先把数字摆出…> 重复 → 重要度 1.00
三处值得盯。
一、「今天天气不错」被直接跳过。 不是因为它没用,是因为它对未来的任务没用。判据不是「这句话有没有信息」,而是「下次做别的事时,它会不会改变我的决定」。按这个标准,客套和过程性废话都该扔。
二、重复的那句没有新增一条,而是把重要度顶到 1.00。 用户第二次说同一件事,是在给你加权,不是在给你新数据。这一步不做,检索库里会有五条几乎一样的偏好,全被 top-k 捞出来,把预算吃光。
三、去重阈值是个经验值,别照抄。 这里用 0.75 是因为我用的是字符哈希向量;换成真正的 embedding,近似重复通常落在 0.90 以上,阈值要重测。太低会把「SQLite」和「Postgres」合并成一条——这种错比不合并严重得多。
检索:相关性是门票,不是排名
存进去只是开始。取出来时最常见的错误,是把相关性、新鲜度、重要度揉成一个分数直接排序——看起来合理,实际上会让「重要但无关」挤掉「相关但普通」。正确做法是两道关:先按相关性设门槛,过线的再按综合分排序;门槛之下的,再重要再新鲜也不取。
    def search(self, query, now, k=3, rel_gate=0.15):
        q = to_vec(query)
        rows = []
        for m in self.items:
            rel = cos(q, m.vec)
            recency = math.exp(-(now - m.day) / 10)      # 10 天半衰
            score = 0.60 * rel + 0.25 * recency + 0.15 * m.importance
            rows.append((rel >= rel_gate, score, rel, recency, m))
        rows.sort(key=lambda r: (not r[0], -r[1]))       # 过线的排前面

        picked = []
        for passed, score, rel, rec, m in rows:
            take = passed and len(picked) < k
            print(f"  {m.text[:24]:<26}{rel:>7.2f}{rec:>7.2f}{score:>7.2f}"
                  f"  {'✓ 取' if take else ('× 过不了线' if not passed else '× 超 k')}")
            if take:
                picked.append(m)
        return picked
查询「定价文章开头怎么组织」,六条记忆的打分:
  记忆                            相关性     新鲜     总分  结果
  以后写定价文章,先把数字摆出来,再讲道理。        0.21   0.74   0.46  ✓ 取
  上周那篇定价文章写了三种模型,读者反馈案例要放前     0.26   0.67   0.40  ✓ 取
  我喜欢用表格对比方案。                  0.11   0.67   0.37  × 过不了线
  我们决定这个项目用 SQLite,不上 Post     0.12   0.55   0.34  × 过不了线
  报错修好了,是时区问题。                 0.10   0.61   0.29  × 过不了线
  我的项目写过一篇印度市场定价的文章,重点是本地化     0.13   0.41   0.22  × 过不了线
看第三行:「我喜欢用表格对比方案」总分 0.37,离被取出的第一条(0.46)不算远,可它的相关性只有 0.11——过不了门槛,再新鲜也不取。这就是门票的意义:总分高不等于该进上下文。
最后一行更值得看。它和查询共享「定价」「文章」,是典型的关键词撞车:语义上它讲印度市场的支付本地化,跟「开头怎么组织」毫无关系。字符相似度给了 0.13,语义模型只会更低,门槛都挡得住。只按「有没有共同词」检索,这条就会被捞出来,模型拿着它去写开头。
工作记忆:预算到了就得动手
Agent 每一轮都在往上下文里加东西:对话、工具返回、检索片段、系统提示。预算一定到顶,区别只在于你主动压缩,还是让 API 报错。
压缩的基本形状是滚动摘要:固定 system,把最早一批原文压成摘要,只留最近一轮问答的原文。关键是留什么——按时间留是错的,要按「事实性」留。
    def _compact(self):
        """保留最近一轮问答,其余压成摘要——摘要只留「事实类」句子。"""
        old, self.recent = self.recent[:-2], self.recent[-2:]
        facts = []
        for _, text in old:
            for seg in re.split(r"[;。]", text):
                if re.search(r"偏好|决定|目标|约束|数字|改成|\d", seg):
                    facts.append(seg.strip())
        add = ";".join(facts) or "(无关键事实:讨论过开头写法)"
        self.summary = (self.summary + ";" if self.summary else "") + add
        if len(self.summary) > self.summary_cap:       # 摘要自己也会膨胀
            self.summary = self.summary[-self.summary_cap:]
        print(f"    [压缩] {len(old)} 条原文 → 摘要 {ntok(self.summary)} tok,"
              f"上下文 {self.used()}/{self.budget}")
预算设 100 token,跑五轮:
  装入 system:15/100 tok
  第 1 轮:15 → 30/100 tok(累计压缩 0 次)
  第 2 轮:30 → 58/100 tok(累计压缩 0 次)
  第 3 轮:58 → 81/100 tok(累计压缩 0 次)
    [压缩] 2 条原文 → 摘要 26 tok,上下文 93/100
  第 4 轮:81 → 93/100 tok(累计压缩 1 次)
    [压缩] 1 条原文 → 摘要 33 tok,上下文 87/100
  第 5 轮:93 → 87/100 tok(累计压缩 2 次)
压缩之后,上下文实际长这样:
你是写作助手,风格:直接、给数字。
[前面的对话摘要] 解释中间档为什么最重要;数字改成 9/29/99,并说明中间档承接了多少付费用户
assistant: 改为 9/29/99 美元;中间档承接了 78% 的付费用户。
user: 再补一句退款政策。
这里藏着一个几乎没人提的坑:摘要把最早那批数字吃掉了。 第一轮定下的「19/49/199 美元」不见了,只剩后面改过的 9/29/99。因为摘要有长度上限,超了就从尾部截断,先丢的恰好是最早的事实。
这不是 bug,是压缩的固有性质:摘要按时间丢信息,而重要事实往往出现在早期。 所以解法不是把摘要调大,而是凡不能丢的事实(价格、约束、决定、偏好),写进对话的同时也写进长期记忆。 摘要会丢,长期记忆不会——图 1 里「写入器」和「压缩器」并行,就是为了这个。
RAG 不是记忆
RAG 和记忆在代码层面长得几乎一样:切块、向量化、检索、拼进上下文。混为一谈的后果是拿 RAG 干记忆的活,怎么调都不对。
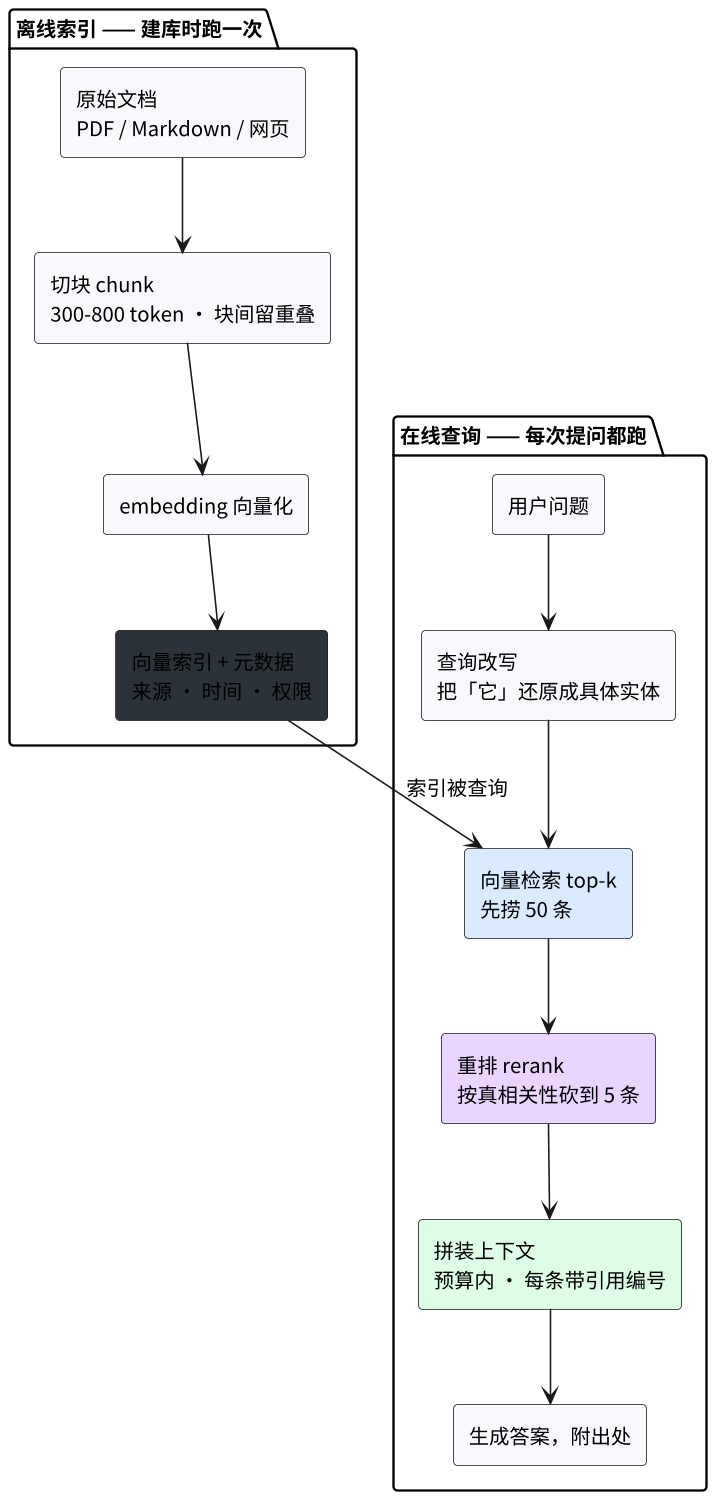
两者的差别只有一条,但这条决定一切:写入权在谁手里。
| RAG | 记忆 | |
|---|---|---|
| 数据来源 | 外部文档:手册、合同、知识库 | Agent 自己的经历:对话、决策、结果 |
| 谁写入 | 人 / 流水线,离线批量 | Agent 自己,在线、随时 |
| 更新频率 | 低,重建索引 | 高,一条一条 upsert |
| 错了怎么办 | 改文档、重跑索引 | 衰减、覆盖、删除 |
| 回答的问题 | 「文档里怎么写的」 | 「我们之前是怎么做的」 |
拿这张表套一个常见错误:把「用户偏好」写进 RAG 索引。技术上能跑,但立刻会撞上三个问题——每条新偏好都要动索引;旧偏好不会自动失效;检索时它和产品文档抢同一个 top-k。偏好进记忆,文档才进 RAG。
图上的重排也是同理:向量检索召回高、精度低,交叉编码器精度高、跑得慢,所以先捞 50 条再砍到 5 条。省掉这步,上下文里就会混进一堆「看起来相关」的段落——和关键词撞车是同一种病。
一次任务里,读写长什么样
把三层拼起来,一次真实任务的时序是这样的:
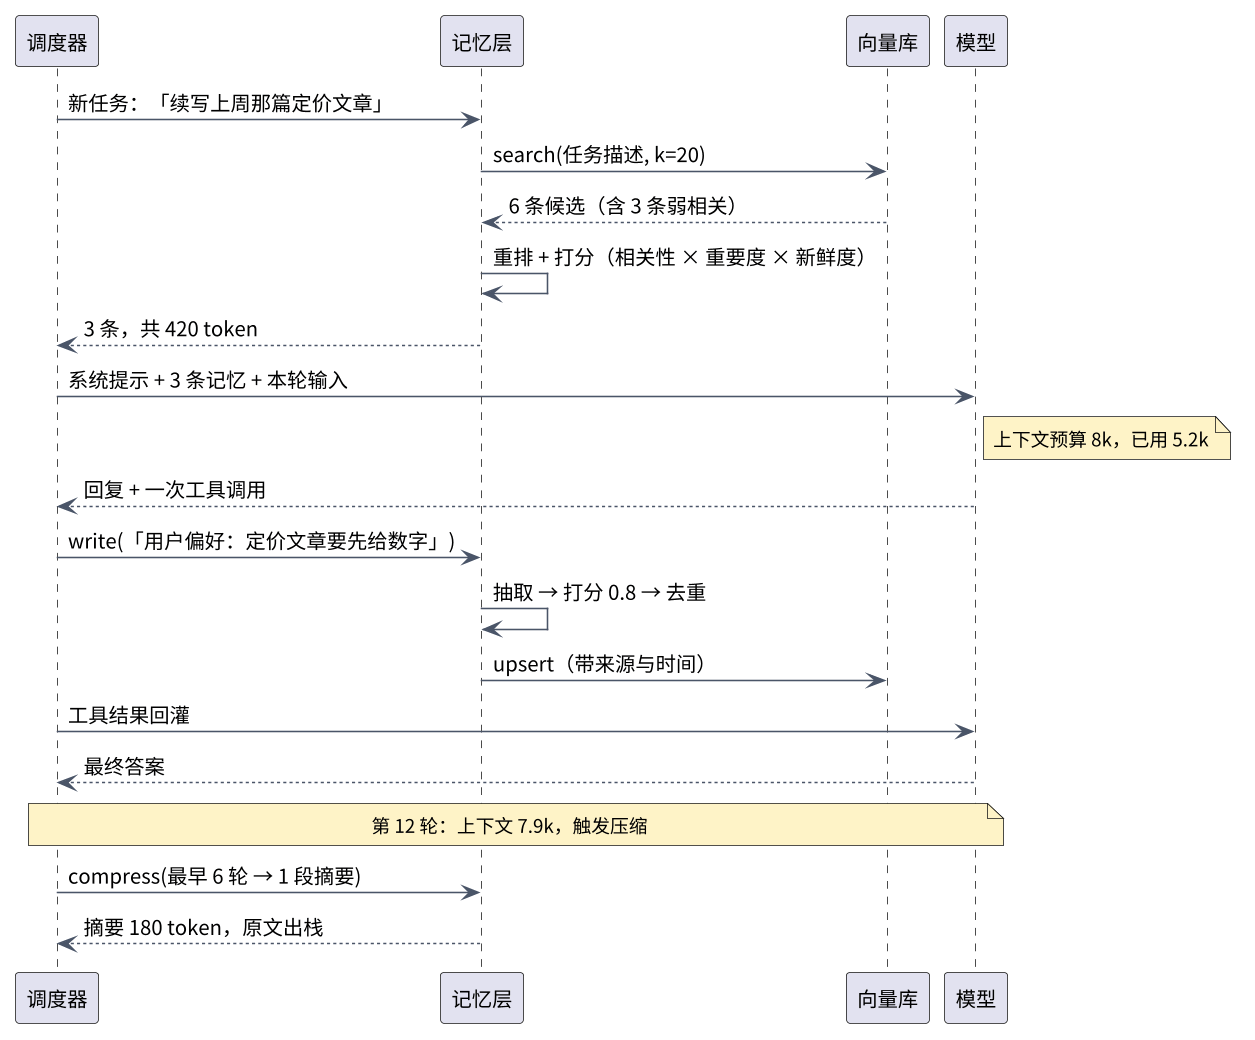
三个细节值得单独说:
一、检索的 query 是「任务描述」,不是「用户最后一句话」。 「续写上周那篇」本身没有信息量,能检索到东西的是「续写定价文章」这个意图。
二、检索在推理前,写入在推理后。 顺序反了会漏掉这一轮新产生的信息;写入的也不是整段对话,而是「用户偏好:定价文章先给数字」这种抽出来的句子。
三、压缩是被预算触发的,不是按轮数。 按轮数压缩(比如「每 10 轮压一次」)在工具返回很长的任务里会直接爆掉,因为一轮就可能吃掉几千 token。触发器必须是 used > budget,不是轮数。
三个反直觉的结论
一、记忆系统的质量由写入策略决定,不由向量库决定。 换一个更贵的向量数据库,检索精度可能提升几个点;把「什么该记」想清楚,检索结果的相关性能翻倍。前者是花钱,后者是设计。
二、遗忘是功能,不是缺陷。 没有 TTL、没有重要度衰减、没有硬删除的系统,三个月后一定变成垃圾场:捞出来的全是过期事实,用户改了主意,它还在坚持旧偏好。GDPR 的「被遗忘权」只是把这件事变成了法律要求。
三、RAG 让 Agent 知道得更多,记忆让它更像「同一个人」。 前者扩知识边界,后者保一致性。用户感到「这个助手懂我」,几乎全来自记忆——文档谁都能读,而「上次你说要先给数字」只有记得住才说得出来。
记住这一件事
一句话:记忆不是存储,是三次决策——写不写、放哪层、取哪条。 门槛决定信噪比,分层决定谁负责丢,两道检索关决定上下文里装的是事实还是噪音。那张桌子永远不够大,功夫全在桌子外面。
下一篇换个方向,从「一个 Agent 怎么记」跳到「一群框架怎么选」:LangChain vs CrewAI vs AutoGPT,同一个任务跑三遍,看它们各自把复杂度藏在了哪里。
AI Agent 全解析系列:
1. AI Agent 是什么——从 LLM 到自主智能体的进化
2. Agent 的四大核心能力:规划、记忆、工具、执行
3. 2026 AI Agent 全景图:谁在做什么,谁能用
4. 选 Agent 还是选 Copilot?不同场景的决策框架
5. Agent 的架构模式:ReAct、Plan-Execute、Multi-Agent
6. 工具调用深度解析:Function Calling、MCP 协议与插件生态
7. 👉 Agent 的记忆系统:短期记忆、长期记忆与 RAG(本文)
💬 Comments