AI Agent 全解析:工具调用深度解析——Function Calling、MCP 协议与插件生态
一个被名字坑了的机制
上一篇(Agent 的架构模式)结尾留了一句话:ReAct、Plan-Execute、Multi-Agent 三种骨架,都绕不开同一根管子——工具调用。这篇把这根管子彻底拆开。
先拆掉一个误解。Function Calling 这个名字起得很糟。它听起来像是模型自己把函数跑了,实际上模型一个函数都不会执行。它输出的是一段结构化文本,大意是「我想调 get_weather,参数是 city=北京」,然后停下。
真正去执行 get_weather 的,是你写的应用代码。模型负责决定,你的代码负责执行。这条线画在哪,直接决定了 Agent 能干什么、又会闯什么祸。
先看一次调用长什么样,再往下拆。
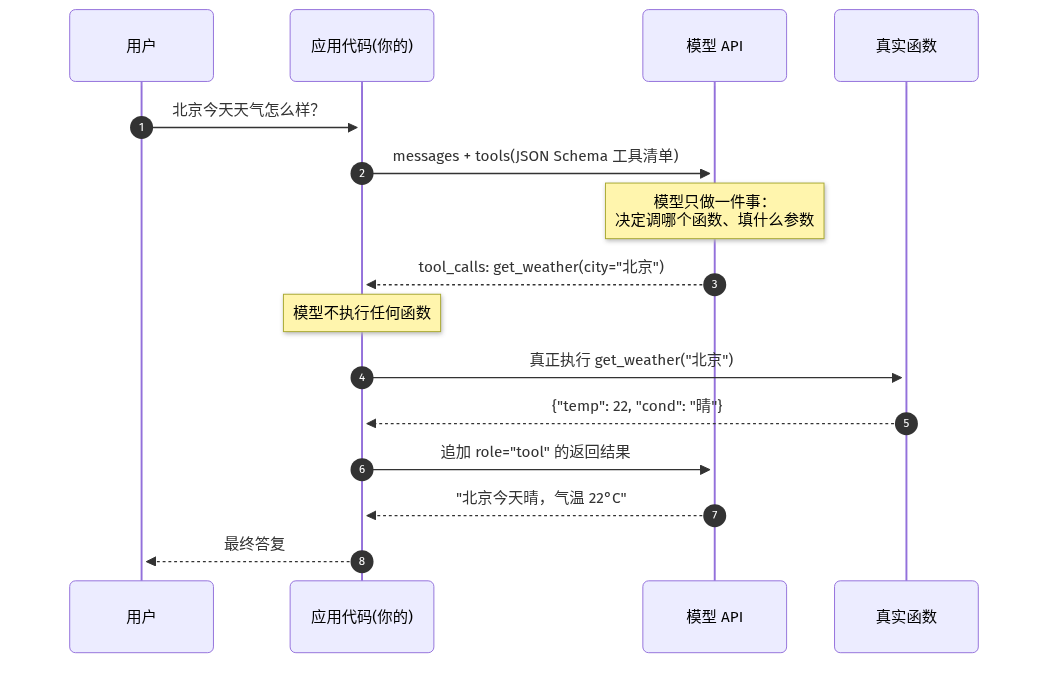
一次工具调用的完整往返
图上四个角色、八个步骤。多数人只记得「模型会用工具」,漏掉的恰恰是让它真正跑起来的三件事。
一、往返至少两轮。 第一轮你把用户的话和工具清单一起发过去,模型不回答案,只回 tool_calls;你执行完,把结果补进对话,再发一次,模型才写人话。工具调用从来不是一次请求能结束的事,这也解释了为什么它比纯聊天慢、比纯聊天贵。
二、工具清单本身就是提示词。 你发过去的那段 JSON Schema——工具叫什么、参数什么类型、每个参数什么意思——和系统提示词一样决定模型行为。描述写得含糊,模型就选错工具、填错参数。这不是模型不行,是你没把需求讲清楚。
三、执行权在你手里。 模型给的是「建议调用」:调哪个函数、传什么参数,你可以完全不听——校验参数、拒绝危险操作、把错误换成人话塞回去,全都在你这一侧完成。模型越不了这堵墙,除非你自己把墙拆了。
代码:一次完整往返长什么样
下面这段把往返的每一步都摊开:工具怎么定义、参数怎么校验、执行失败了怎么把错误喂回模型让它自己纠。为了不依赖真实 API,模型的决策我用一个脚本化函数代替——协议和边界才是主角,模型只是那个填表的角色。
#!/usr/bin/env python3
"""AI Agent 全解析 · 06 配套代码
Function Calling 的最小完整往返:
工具定义 -> 模型决策 -> 参数校验 -> 执行 -> 结果回灌 -> 收口。

不调真实模型,用一个确定性的「决策器」代替 LLM——
重点看三件事:工具描述怎么写、参数怎么校验、失败怎么回灌给模型。
运行:python3 tool_calling.py
"""
from __future__ import annotations
import json

# ---- 1. 工具定义:name + description + JSON Schema ----
TOOLS = [
    {
        "name": "get_weather",
        "description": "查询某个城市当前的天气。当用户问某个城市今天/现在的天气时使用。",
        "parameters": {
            "type": "object",
            "properties": {
                "city": {"type": "string", "description": "城市名,如 北京、上海"},
                "unit": {"type": "string", "enum": ["celsius", "fahrenheit"], "default": "celsius"},
            },
            "required": ["city"],
        },
    },
    {
        "name": "calc",
        "description": "计算一个数学表达式,只支持 + - * / ( )。需要做算术时使用。",
        "parameters": {
            "type": "object",
            "properties": {"expr": {"type": "string", "description": "如 (27-22)/22*100"}},
            "required": ["expr"],
        },
    },
]

DB = {"北京": 22, "上海": 27, "广州": 31}


def _get_weather(city, unit="celsius"):
    if city not in DB:
        raise ValueError(f"没有 {city} 的天气数据")
    t = DB[city]
    if unit == "fahrenheit":
        t = round(t * 9 / 5 + 32)
    return {"city": city, "temp": t, "unit": unit}


def _calc(expr):
    allowed = set("0123456789+-*/(). ")
    if not set(expr) <= allowed:
        raise ValueError("表达式含非法字符")
    return round(eval(expr, {"__builtins__": {}}, {}), 2)


HANDLERS = {"get_weather": _get_weather, "calc": _calc}


# ---- 2. 参数校验 + 执行:把错误变成给模型的「可读反馈」----
def call_tool(name, args):
    spec = next((t for t in TOOLS if t["name"] == name), None)
    if spec is None:
        return {"error": f"未知工具 {name}"}
    missing = [k for k in spec["parameters"].get("required", []) if k not in args]
    if missing:
        return {"error": f"缺少必填参数:{missing}"}
    try:
        return {"result": HANDLERS[name](**args)}
    except Exception as e:                      # 关键:不抛出,而是回灌
        return {"error": f"{type(e).__name__}: {e}"}


# ---- 3. 模型侧(真实场景里这是 API 返回的 tool_calls)----
def _temps(messages):
    """从回灌的工具结果里把温度捞出来,模拟模型「读到了结果」。"""
    out = {}
    for m in messages:
        if m.get("role") == "tool":
            r = json.loads(m["content"]).get("result")
            if isinstance(r, dict) and "temp" in r:
                out[r["city"]] = r["temp"]
    return out


def model_decide(messages):
    """真实场景:把 messages 发给模型,拿回 tool_calls。这里脚本化,保证可复现。"""
    n = sum(1 for m in messages if m.get("role") == "tool")
    if n == 0:
        # 第一轮:「火星」是我故意塞的错误参数,用来看错误怎么被兜住
        return [{"id": "c1", "name": "get_weather", "args": {"city": "北京"}},
                {"id": "c2", "name": "get_weather", "args": {"city": "火星"}}]
    if n == 2:
        return [{"id": "c3", "name": "get_weather", "args": {"city": "上海"}}]
    if n == 3:
        t = _temps(messages)
        expr = f"({t['上海']}-{t['北京']})/{t['北京']}*100"
        return [{"id": "c4", "name": "calc", "args": {"expr": expr}}]
    return None                                  # 收口


def run(user_input, max_rounds=5):
    messages = [{"role": "user", "content": user_input}]
    for _ in range(max_rounds):
        calls = model_decide(messages)
        if not calls:
            print("模型收口,结束。")
            return
        messages.append({"role": "assistant", "tool_calls": calls})
        for c in calls:
            out = call_tool(c["name"], c["args"])
            print(f"  -> {c['name']}({c['args']}) = {out}")
            messages.append({"role": "tool", "tool_call_id": c["id"],
                             "content": json.dumps(out, ensure_ascii=False)})
    print("达到最大轮数,强制停止——这就是死循环的兜底。")


if __name__ == "__main__":
    run("北京和上海今天温度差多少百分比?")
跑出来的真实输出:
  -> get_weather({'city': '北京'}) = {'result': {'city': '北京', 'temp': 22, 'unit': 'celsius'}}
  -> get_weather({'city': '火星'}) = {'error': 'ValueError: 没有 火星 的天气数据'}
  -> get_weather({'city': '上海'}) = {'result': {'city': '上海', 'temp': 27, 'unit': 'celsius'}}
  -> calc({'expr': '(27-22)/22*100'}) = {'result': 22.73}
模型收口,结束。
三处值得盯。
一、「火星」那一步是我故意塞的错误参数。 call_tool 没有让异常冒出来炸掉程序,而是把它包成 {"error": "..."} 回灌给模型。模型看到这个 error,下一轮自动换成了合法城市。这就是工具调用比传统 API 调用聪明的地方:错误不是终点,是下一轮的输入。
二、必填参数是在执行之前校验的。 missing 那段检查跑在调用函数之前,缺参数就直接返回错误,不浪费一次真实执行,也避免带着半截参数去碰数据库。
三、_calc 对表达式做了白名单过滤。 这里用的是 eval,Python 里最危险的内建函数之一。让模型填参数,意味着这些参数可能来自用户、也可能被提示注入污染——任何「把模型输出直接丢给 eval / SQL / shell」的写法,都是事故预备役。 白名单是底线,不是可选。
MCP:把 N×M 拧成 N+M
Function Calling 解决的是「模型怎么调工具」。但很快你会撞上第二个问题:同一个工具,要在每个模型、每个应用里各接一遍。
三个模型(OpenAI、Anthropic、本地开源)乘以两个工具(搜索、数据库),就是六套适配代码;模型或工具再各加一个,组合数立刻膨胀。这就是经典的 N×M 集成地狱——每加一个东西,都要重连一圈。
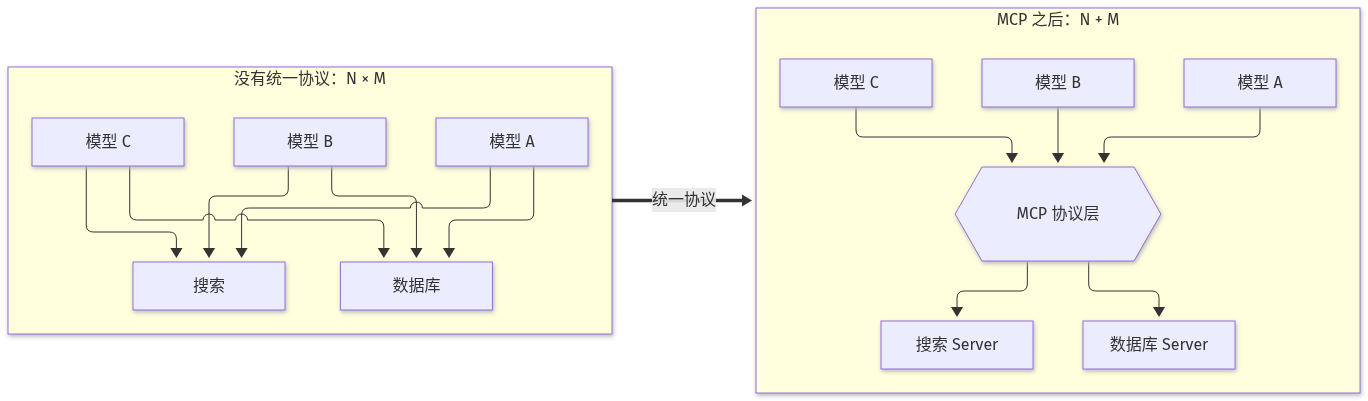
MCP(Model Context Protocol)想做的只有一件事:在「模型应用」和「工具服务」之间定一个统一协议,把 N×M 拧成 N+M。工具方按协议实现一次自己的 Server,所有支持 MCP 的应用就都能直接用。
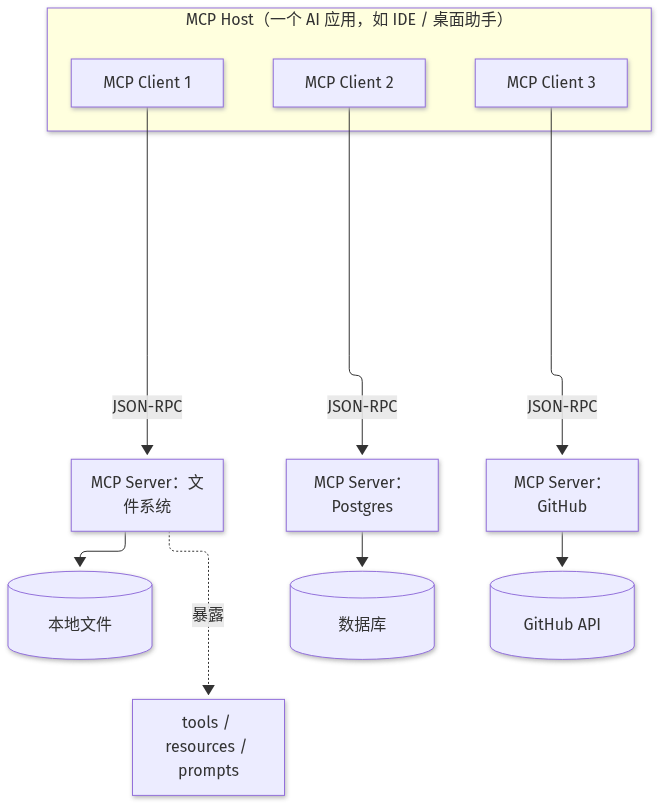
架构上分三层:Host 是那个 AI 应用本身(IDE、桌面助手);Client 是 Host 内部维护的连接,一个 Client 对接一个 Server;Server 是工具方写的适配层,把本地文件、数据库、GitHub 这些真实能力,按协议暴露出来。Host 和 Server 之间走 JSON-RPC,通常是本地 stdio 或 SSE。
MCP 的 JSON-RPC 长什么样
MCP 走的是 JSON-RPC 2.0,最常用的就两个方法:列工具、调工具。下面是 Server 端的最小骨架,把协议长相摊开看:
# mcp_server_weather.py — MCP Server 的最小骨架(JSON-RPC over stdio)
# 真实实现用官方 SDK 几行就能起,这里手写是为了让你看清报文长什么样。
import json
import sys


def tools_list():
    return {"tools": [{
        "name": "get_weather",
        "description": "查询某城市当前天气",
        "inputSchema": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
        },
    }]}


def tools_call(name, arguments):
    if name != "get_weather":
        return {"isError": True, "content": [{"type": "text", "text": f"未知工具 {name}"}]}
    city = arguments.get("city")
    return {"content": [{"type": "text", "text": f"{city} 今天 22°C 晴"}]}


HANDLERS = {
    "tools/list": lambda p: tools_list(),
    "tools/call": lambda p: tools_call(p["name"], p.get("arguments", {})),
}


def main():
    for line in sys.stdin:                       # 一行一个 JSON-RPC 报文
        req = json.loads(line)
        method = req.get("method")
        # 连接建立时的 initialize 握手这里省略
        result = HANDLERS[method](req.get("params", {})) if method in HANDLERS else None
        print(json.dumps({"jsonrpc": "2.0", "id": req.get("id"), "result": result}),
              flush=True)


if __name__ == "__main__":
main()对照上一段代码你会发现:MCP 的 inputSchema 就是 Function Calling 的 parameters,tools/call 就是那个 call_tool 分发函数。 MCP 没有发明新魔法,它只是把「你已经写过的工具定义 + 分发逻辑」标准化成了一条进程间协议。看穿这点,MCP 那堆名词就塌了一半。
MCP 的三个原语:tools / resources / prompts
MCP 不只有工具,它定义了三类能力,区别在「有没有副作用」:
| 原语 | 是什么 | 有副作用吗 | 典型例子 |
|---|---|---|---|
| tools | 可执行的动作 | 有 | 发邮件、写文件、下单 |
| resources | 只读的上下文数据 | 无 | 日志文件、数据库表、文档 |
| prompts | 预置的提示模板 | 无 | 代码审查模板、周报模板 |
记住一条分界线:有副作用、要模型自己决定「做什么」的 → tools;只是给模型看的资料 → resources;把人写好的提示词固化下来复用 → prompts。 最常见的错位是把只读数据也塞进 tools,结果模型每次都要「调用」一下才读得到——该用 resources 的地方用了 tools,白白多一轮往返。
插件生态:Function Calling 之后的三年
这条演进线很短,理一遍就不会被名词绕晕:
- 各家 function calling 阶段。 OpenAI、Anthropic、Google 各自定义工具调用格式,名字不一样(tools / tool use / function declarations),参数结构高度相似,但 Schema 细节和返回格式并不完全一致。想跨模型复用同一套工具,得自己写一层适配。
- Plugins 试水与退场。 OpenAI 2023 年推的插件体系过于中心化、上架审核慢,很快被 GPTs 和 Actions 取代——本质还是 function calling,只是换了个壳,生态并没有真的长起来。
- MCP 成为事实标准。 2024 年底 Anthropic 把 MCP 开源,2025 年 OpenAI 等相继宣布支持。它的价值不在技术多新,而在于「终于有一个大家都点头的接口」。 工具生态的规模效应第一次真正跑了起来:Server 写一次,处处可用。
所以插件生态现在的样子是:底层协议收敛到 MCP,上层各家还在拼体验。 对独立开发者来说,这是三年来第一次可以「写一次工具、到处挂载」——门槛降下来了。
三个反直觉的结论
一、决定工具调用质量的,是你的工具描述,不是模型的智商。 模型选错工具,九成是因为 description 写得含糊或工具之间语义重叠。花半小时把每个工具的「什么时候用、什么时候不用」写清楚,收益远大于换一个更贵的模型。
二、Function Calling 的本质不是「让模型做事」,是「让模型填表」。 它产出的是结构化参数,真正动作永远由你的代码执行。想通这一点,你就不会再把危险操作直接暴露给模型——因为你清楚那张表是你自己在填后执行的。
三、MCP 不提升任何智能,它只降低集成成本。 它解决的是工程问题:一份工具定义,几个应用都能用。别指望接上 MCP 模型就变聪明,它变的是「你可用的工具多了、接得便宜了」。
记住这一件事
一句话:工具调用是一条往返管道——模型只负责决定和填表,执行、校验、兜错全在你这一侧。 Function Calling 是这根管子的内容格式,MCP 是把它标准化成 N+M 的那层协议,插件生态则是这根管子接出来的活水。判断一个 Agent 靠不靠谱,先看它的工具描述和错误兜底写得怎么样——这两处,比模型名字更能说明问题。
下一篇顺着往下钻:模型怎么在多次工具调用之间记住已经发生了什么——Agent 的记忆系统,短期记忆、长期记忆与 RAG。
AI Agent 全解析系列:
1. AI Agent 是什么——从 LLM 到自主智能体的进化
2. Agent 的四大核心能力:规划、记忆、工具、执行
3. 2026 AI Agent 全景图:谁在做什么,谁能用
4. 选 Agent 还是选 Copilot?不同场景的决策框架
5. Agent 的架构模式:ReAct、Plan-Execute、Multi-Agent
6. 👉 工具调用深度解析:Function Calling、MCP 协议与插件生态(本文)
💬 Comments