AI Agent 全解析:LangChain vs CrewAI vs AutoGPT——三个框架把复杂度藏在了哪里
三个框架不在同一层
上一篇(Agent 的记忆系统)结尾说,这篇要把同一个任务跑三遍。跑之前先拆一个更常见的误解:LangChain、CrewAI、AutoGPT 不是三个同类产品。
它们分别长在三个不同的位置上:LangChain 是一套库,卖给你零件——Chain、Tool、Retriever、Checkpointer,怎么接是你的事;CrewAI 是一套组织模型,卖给你角色和任务,谁干什么、交给谁写在 Agent 的 role/goal 里;AutoGPT 现在更像一个产品,经典版是「给个目标它自己规划」的黑箱,Platform 版是拖 Block 连图的可视化工作台。
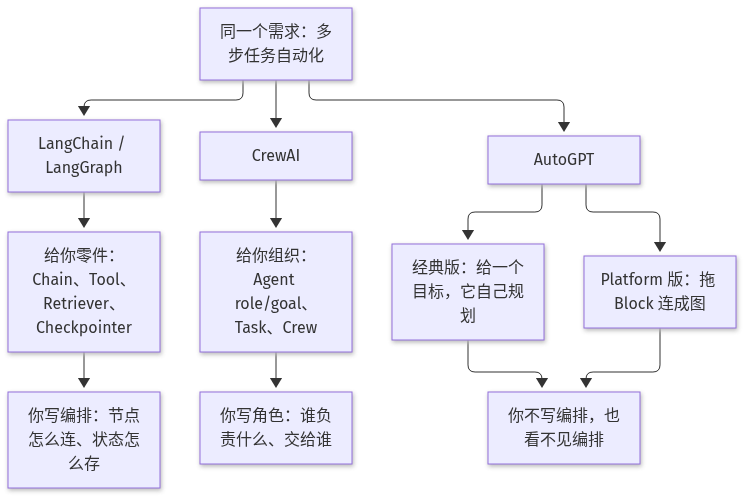
把这三样东西摆成「三选一」,就会撞上一批很典型的错:拿 CrewAI 去做一个需要断点续跑、跑三天不停的长任务——它没有 checkpoint,进程一挂全丢;拿 LangChain 手搓三个角色互相评审,写了 400 行状态机;或者更常见的,把 AutoGPT 的「自主循环」直接搬进生产,账单和延迟都不可预测。
所以正确的问法不是「哪个框架更好」,而是「这层复杂度,我愿意自己拿在手里,还是想交给框架藏起来」。
同一个任务跑三遍
为了看清「藏」这件事,我写了个对照脚本:不调真实 API,用一个按剧本回话的假模型,只观察编排本身。任务很朴素——读三篇草稿,抽出定价数字,产出对比表。这个任务够小,才能看清每个框架多出来的那几步到底花在哪。
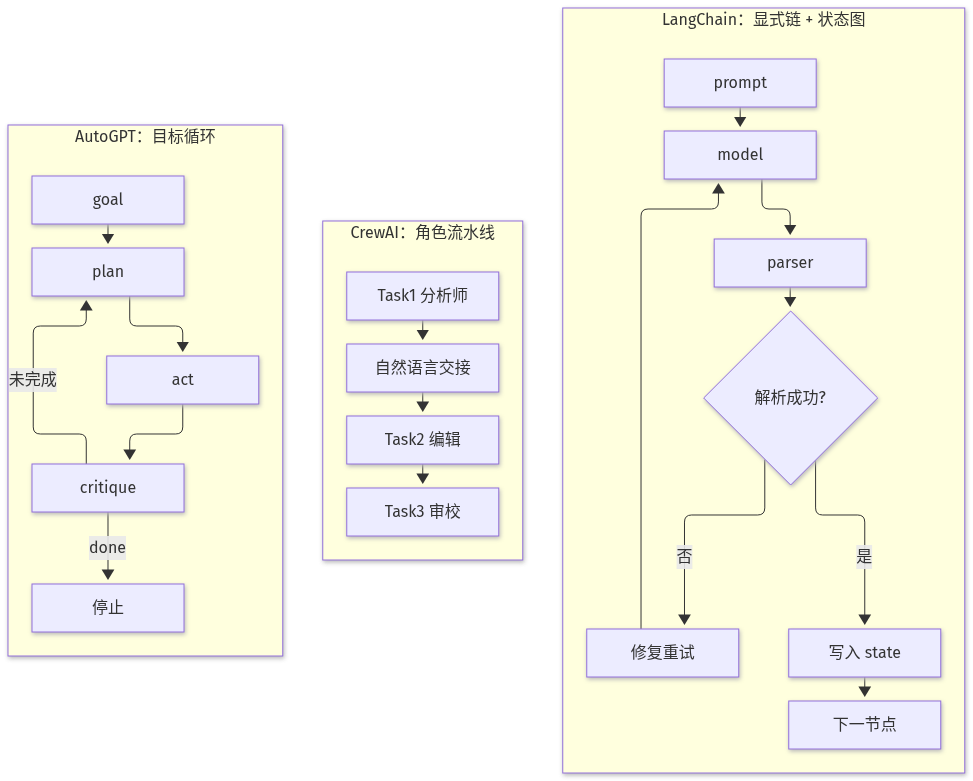
先看 LangChain 那一版的核心——三段式加一个解析兜底,这是它的日常形状:
def lc_extract(llm, doc):
    prompt = f"从下面文本抽取 pricing,输出 JSON:{{name, price, note}}\n{doc}"
    raw = llm(prompt)
    try:
        return json.loads(raw), None
    except json.JSONDecodeError:
        return None, f"解析失败:{raw[:28]}"

for doc in DOCS:
    data, err = lc_extract(llm, doc)
    if err:                                   # OutputFixing:重问一次
        data, err = lc_extract(llm, doc + "\n只输出 JSON,不要代码块")
CrewAI 那一版没有解析器,取而代之的是角色与任务:
extractor = Agent("定价分析师", "从文档抽取价格结构", llm_a)
writer    = Agent("技术编辑",   "把结论写成对比表",   llm_b)
tasks = [
    Task("读取三篇草稿并汇总定价", "三档价格清单", extractor),
    Task("基于上一步产出 markdown 对比表", "markdown 表格", writer),
]
ctx = ""
for t in tasks:                               # sequential process
    prompt = (f"角色:{t.agent.role}|目标:{t.agent.goal}\n"
              f"任务:{t.desc}\n期望产出:{t.expected}\n上文:{ctx}")
    ctx += f"\n[{t.agent.role}] {t.agent.llm(prompt)}"
AutoGPT 那一版最短,也最不透明——循环自己决定停不停:
log.append(f"plan → {llm(goal)}")
while steps < max_iter:
    steps += 1
    act  = llm(f"goal={goal} step={steps}")
    crit = llm(f"评估上一步:{act}")
    if '"done":true' in crit:
        break
跑出来的真实输出:
====================================================================
任务:三篇草稿 → 定价对比表
====================================================================

[A] LangChain 风格:prompt | model | parser
  doc1: model调用 → 解析失败:```json
{"name":"基础版","price
         retry → OK
  doc2: model调用 → OK
  doc3: model调用 → OK
  产出:3 行,重试 1 次,model 调用 4 次,~124 tok

[B] CrewAI 风格:role/goal/backstory + Task + sequential Crew
  定价分析师 → 55 字符
  技术编辑 → 75 字符
  产出:2 个 Task,交接靠自然语言 147 字符,调用 2 次,~125 tok

[C] AutoGPT 风格:goal 循环 + 自我批评 + 重规划
  plan → {"plan":["读取三篇草稿","抽取价格","生成对比表"]}
  step1 行动 → {"action":"read_docs","result":"3 篇草稿已读"}
  step1 自评 → {"critique":"还缺价格数字","next":"抽取三档价格"}
  step2 行动 → {"action":"extract_prices","result":"9/29/199"}
  step2 自评 → {"critique":"表格未生成","next":"生成 markdown 表"}
  step3 行动 → {"action":"write_table","result":"三行表格已写入 out.md"}
  step3 自评 → {"critique":"完成","done":true}
  产出:3 轮循环,调用 7 次,~124 tok

====================================================================
框架           LLM调用   ~token        控制流可读性          失败模式
LangChain        4      124       高(显式图)         解析失败
CrewAI           2      125      低(藏在角色)         交接漂移
AutoGPT          7      124      最低(循环内)         停不下来
====================================================================
三处值得盯。
一、token 数几乎一样,124 / 125 / 124。 这是整张表最反直觉的地方:三个框架谁都没帮你省 token。省钱的地方从来不在编排框架,而在你塞进上下文的那些东西——上一篇讲的三层记忆、检索门槛、滚动摘要,才是动预算的杠杆。框架省的是调试时间,不是钱。(这里只计了输入侧,输出侧会拉开差距,但差距来源是「多问了几轮」,不是「框架更聪明」。)
二、LangChain 多出的那一次调用,浪费在 markdown 围栏上。 真实模型极爱回 ```json 包起来的 JSON。这次浪费是可定位的:报错点明确指向 parser,重试策略也明确挂在那一行。这就是显式控制流的价值——失败发生在你能看见的地方。
三、CrewAI 只用两次调用就完成了,代价是那 147 字符的「自然语言交接」。 上一步的输出整段塞进下一步的 prompt,字段名从 price 漂成 价格、从 9 漂成 $9/月,没有任何一层会在编译期或运行期拦住你。任务一多,你会开始怀疑是模型不行,其实是交接契约根本不存在。
LangChain:给你零件,也给你一堆零件
2025 年 10 月 LangChain 发了 1.0,最重要的一件事是把 agent 建在 LangGraph 之上:Agent 不再是一种特殊对象,而是一张状态图。节点是函数,边是控制流,state 是显式数据结构,还能配 checkpointer 把每一步落盘。
# 1.0 之后的入口(旧版的 AgentExecutor 已经是历史)
from langchain.agents import create_agent

agent = create_agent(model="anthropic:claude-sonnet-4-5", tools=[search, read_file])
result = agent.invoke({"messages": [{"role": "user", "content": "查一下上周的部署记录"}]})它真正的差异化能力只有一句话:可以把一次运行暂停在中途,等人批完再接着跑。 这在需要审批、需要人工确认付款、或者任务要跑几十分钟的场景里,是硬需求,不是加分项。
代价也很具体。一是抽象层多,同一个概念在 0.x 时代有 Chain、Agent、Runnable、Tool 几套并存,搜到的教程一半跑不通;二是版本漂移,1.0 的迁移量不小;三是「零件太多」本身就有成本——你会不自觉地给一个只需 30 行的任务配上 retriever + memory + callback,因为框架都在那儿摆着。
CrewAI:把提示词包装成组织架构
CrewAI 的聪明之处在于借了一个所有人都懂的隐喻:公司。每个 Agent 有三样东西——role(职位)、goal(目标)、backstory(背景),听起来很拟人,落到代码里其实全是拼进 system prompt 的字符串。Crew 负责把 Task 排成顺序,前一个任务的输出自动成为后一个的上下文。
from crewai import Agent, Task, Crew, Process

analyst = Agent(role="定价分析师", goal="从草稿抽出价格结构", backstory="做过 5 年 SaaS 定价")
editor  = Agent(role="技术编辑",   goal="产出可直接发布的对比表", backstory="写过 200 篇产品文档")

crew = Crew(
    agents=[analyst, editor],
    tasks=[Task(description="汇总三篇草稿的定价", expected_output="三档价格清单", agent=analyst),
           Task(description="写成 markdown 对比表", expected_output="markdown 表格", agent=editor)],
    process=Process.sequential,          # 另一个选项是 hierarchical,由一个 manager 派活
)
print(crew.kickoff())它适合什么?流程固定、角色分工清楚、一次跑完就结束的活儿:内容生产线(调研→初稿→审校→排版)、批量报告、多视角评审。这类任务的共同点是:错了重跑一遍成本可接受,不需要中途暂停。
它的坑在于「角色是提示词,不是类型」。role 写得含糊,Agent 就会越界;expected_output 写得含糊,下游拿到的东西就不可解析。你花的调试时间不在代码里,而在反复改 backstory——这也是为什么很多人觉得「CrewAI 上手快、调优玄」。
AutoGPT:从野马到积木
2023 年那个刷屏的 AutoGPT 是「自主性」的极限演示:给一个目标,它自己拆任务、自己上网、自己写文件,然后自己判断做完了没有。它证明了 Loop 能跑通,也证明了 Loop 会失控——最常见的抱怨是它停不下来,或者在第 40 步忘掉最初的目标。
所以现在的 AutoGPT 主体是 Platform:可视化 Block 编辑器,把「取网页」「调 LLM」「写文件」连成一张图。说白了,它已经不是「自主 Agent 框架」,而是一个带 AI 节点的 n8n。这个转身是对的——自主性在 demo 里迷人,在生产里是负债。
经典循环留下的教训,比它的代码值钱:「done」是模型自己说的,不是系统验的。 上面那段输出里,第 3 轮的 {"critique":"完成","done":true} 是假模型按剧本回的;真实模型在没做完时同样会自信地说完成。任何靠自我批评终止的循环,都必须外挂一个硬判据——文件是否存在、表是否是 3 行、字段是否齐全——否则你买的是一台自动生成「已完成」的机器。
怎么选:先问三个问题
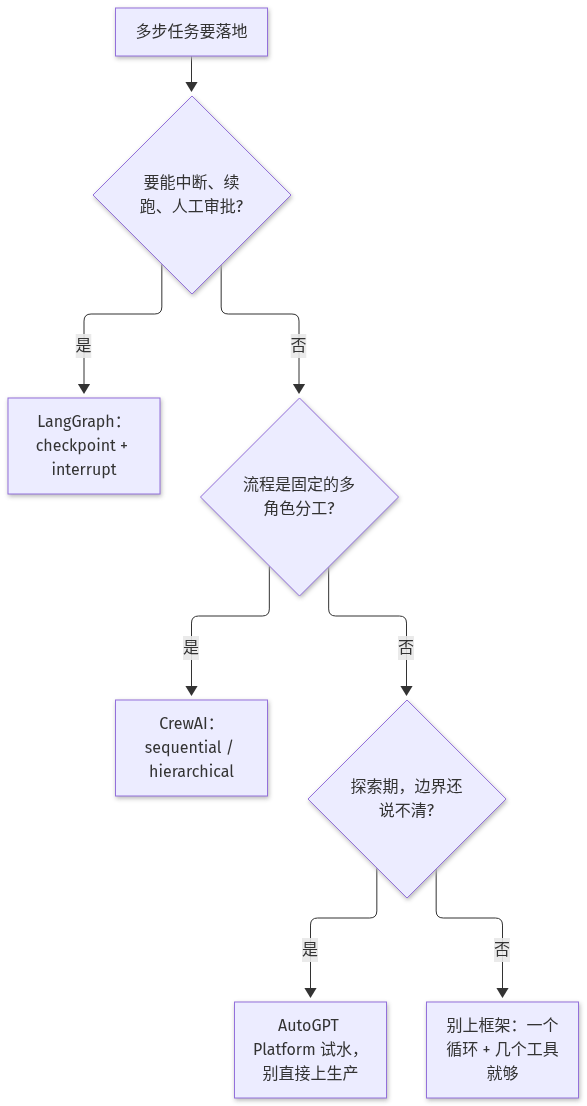
按图走,多数人会走到最下面那个框,这不是玩笑。如果你的任务是一个循环加五六个工具就能搞定的,框架带来的抽象成本会立刻超过收益。 Anthropic 在《Building Effective Agents》里说过同一件事:他们见过的成功案例,大多用的是简单可组合的 pattern,而不是框架。这句话值得每个准备上框架的人先读一遍。
真要选,我的默认搭配是这样:核心链路用 LangGraph 手写状态图(可控、可暂停、可回放),内容/报告类流水线直接用 CrewAI 换速度(一次跑完、重跑便宜),AutoGPT Platform 只用来做原型和内部工具(给别人演示流程长什么样,很省时间)。
还有一条容易被忽略的:别把两套框架混着用。 LangChain 的 Tool 塞进 CrewAI,CrewAI 的 Crew 塞进 LangGraph,看起来可行,实际会得到两套 state 管理和两套重试逻辑,出问题时你连日志都对不齐。
三个反直觉的结论
一、生产环境要的是可恢复性,不是自主性。 线上任务挂了,你需要知道它停在第几步、state 里有什么、能不能从那里续上。checkpointer 和 interrupt 这类「不性感」的功能,比「自己规划」重要一个数量级。自主性让 demo 好看,可恢复性让服务活着。
二、框架不省 token,也不省调用次数,它只挪动复杂度的位置。 上面那张对照表已经说完了:LangChain 把复杂度放在可见的图里,CrewAI 把它藏进角色提示词,AutoGPT 把它藏进循环。选框架本质是选你愿意在哪一层 debug——在代码里,还是在提示词里,还是在日志里猜。
三、多 Agent 常常打不过单 Agent。 每多一个 Agent,就多一次交接、多一层信息损失、多一份 token。三个角色互相评审听起来很美,实际常见的结果是:A 把结论说给 B,B 丢掉一半细节,C 拿着残缺信息给出自信的判断。先把单 Agent 的工具集和系统提示磨好,真的撞到上下文装不下、或者确实需要不同模型分工,再拆。
一句话
LangChain 卖零件,CrewAI 卖组织,AutoGPT 卖成品——买之前先想清楚,你想自己拿着的到底是哪一层。 框架选错的代价从来不是跑不起来,而是跑起来之后,你不知道该去哪里找那个 bug。
下一篇进到代码里:用 LangGraph 构建多步骤 Agent 工作流——状态怎么定义、条件边怎么写、checkpoint 怎么落盘,以及一个能中断在「等人审批」那一步的真实例子。
AI Agent 全解析系列:
1. AI Agent 是什么——从 LLM 到自主智能体的进化
2. Agent 的四大核心能力:规划、记忆、工具、执行
3. 2026 AI Agent 全景图:谁在做什么,谁能用
4. 选 Agent 还是选 Copilot?不同场景的决策框架
5. Agent 的架构模式:ReAct、Plan-Execute、Multi-Agent
6. 工具调用深度解析:Function Calling、MCP 协议与插件生态
7. Agent 的记忆系统:短期记忆、长期记忆与 RAG
8–10. Hermes Agent 入门 / 配置 / Skills(从这里开始)
11. 👉 LangChain vs CrewAI vs AutoGPT:三个框架把复杂度藏在了哪里(本文)
💬 Comments