AI编程工具链:AI 驱动的完整开发工作流——从需求到上线
四个孤立的能力,串起来才是生产力
前四篇我把 AI 编程工具链拆成了四个环节单独讲:Prompt Engineering、AI Debugging、AI 代码审查、AI 自动化测试。单独拎出来,每个都能帮你省不少时间——但如果你只用其中一个,效率提升是「加法」;把它们串成一条流水线,效率提升才是「乘法」。
为什么?因为真实开发里这些环节是环环相扣的:需求没想清楚,代码写得再快也是返工;测试没跟上,审得再细也挡不住线上事故。AI 单独帮你写代码,省的是敲键盘的时间;AI 贯穿全流程,省的是整个返工和沟通的成本。
这篇是系列的最后一篇:把前四篇串起来,讲一套从「一句话需求」到「代码上线」的 AI 驱动工作流。重点只回答一个问题——在每个环节,AI 到底能接多少活,哪些活必须人亲自干。
先看全貌:一条流水线,两个检查点
我把这套工作流画成一张图,六个环节,中间卡着两个必须人参与的「检查点」:
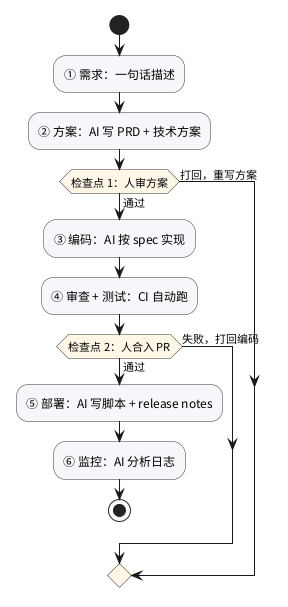
这张图最重要的信息不是「AI 能干多少」,而是那两个检查点的位置:人站在检查点上,不站在键盘前。 AI 负责把每个环节的活干完,人负责在两个关键节点拍板——方案对不对、要不要合并。其余环节 AI 可以全自动跑。
很多人用 AI 开发失败,不是 AI 不够强,而是把 AI 当成了「一条龙」:丢一句话进去,指望它从头写到尾,结果中间哪个环节跑偏了都不知道。这套工作流的核心,就是把「一条龙」拆成「接力赛」,每一棒之间有个交接检查。
环节一:从一句话需求到技术方案
我习惯先不让 AI 写代码,而是让它产出「共识文档」。直接上例子——给订单系统加优惠券叠加功能:
我要给订单系统加优惠券叠加功能。折扣逻辑在 order/discount.py,优惠券表在 order/models.py。先别写代码,分三步走:

1. 写一份 PRD:用户故事、验收标准、边界情况(至少 8 个边界)
2. 写技术方案:涉及哪些文件、改动点、要不要数据库迁移
3. 把实现拆成 3-6 个可独立提交的小任务,按依赖排序

输出 Markdown,存到 docs/coupon-stacking-spec.md这一步的价值不在「文档」,在于逼着需求在动代码之前被想清楚。AI 写出来的 PRD 会列出你没想到的边界:优惠券能不能和会员折扣叠加、能不能叠多张、过期时间边界、金额为 0 的订单怎么处理……这些如果你直接让它写代码,它要么漏掉、要么自由发挥。先落成文档,你和它就有了一个共同的「合同」。审完这个 spec 没问题了,才进入下一步——这就是检查点 1。
环节二:按 spec 实现,一次只做一个任务
spec 审过了,开始写代码。关键原则:一次只让 AI 做一个小任务,任务粒度小到「AI 不会跑偏,你 review 得过来」。
按 docs/coupon-stacking-spec.md 实现任务 1(优惠券表字段 + 数据库迁移)。
只做任务 1,不要动其他任务涉及的文件。
每个函数写 docstring,类型标注风格跟现有代码一致。
完成后跑一下现有测试,确认没破坏别的模块。
为什么「一次一个任务」这么重要?因为 AI 的注意力有限,任务越大越容易自由发挥、越容易漏掉约束。你切得越小,它的输出越可控,你 review 的成本越低。反过来,丢一个大任务让它自己拆,它拆出来的顺序和边界不一定是你想要的。
环节三:审查 + 测试,交给 CI 自动跑
代码写完了,接着是第二、三、四篇讲的审查和测试。这两步别手动触发,接进 CI 每次提交自动跑。一个最小配置:
# .github/workflows/ci.yml
name: CI
on: [pull_request]
jobs:
  ai-review:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: AI Code Review
        env:
          ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
        run: python scripts/ai_review.py
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: "3.11"
      - run: pip install -r requirements.txt pytest pytest-cov
      - run: pytest --cov=app --cov-report=term-missing
两道门都过了,PR 才允许合并——这就是检查点 2:AI 审一遍 diff,机器跑一遍测试,你最后拍板合入。高危改动(支付、鉴权、数据迁移)永远自己再过一眼,别把合入权也交出去。
环节四:收尾自动化——release notes 和部署
合并之后还有一堆收尾活:写 release notes、更新文档、部署、上线后看日志。这些也都能交给 AI。比如让 AI 生成 changelog:
读 main 分支最近 20 个 commit,写一份给用户的 changelog:
- 按「新功能 / 修复 / 改进」分类
- 每条约 15 字以内,中文,去掉内部技术细节
部署脚本这种重复性高的东西,让 AI 生成骨架,你审一遍再上:
# deploy.py —— AI 生成的零停机部署脚本骨架
import subprocess

def deploy():
    subprocess.run(["git", "pull", "origin", "main"], check=True)
    subprocess.run(["docker", "compose", "build"], check=True)
    subprocess.run(["docker", "compose", "up", "-d"], check=True)
    print("deployed")

if __name__ == "__main__":
    deploy()
上线后的日志分析也交给 AI:把报错堆栈丢给它定位,把慢查询日志丢给它找瓶颈。这些是定时巡检的拿手活,上一篇讲测试的时候也提过。
AI 能接多少活?一张清单
把六个环节里 AI 的「接活比例」和「人必须干的活」列清楚,方便你对照自己项目调整:
| 环节 | AI 接活比例 | 人必须做的事 |
|---|---|---|
| 需求 → PRD | 70% | 拍板需求对不对、验收标准 |
| PRD → 方案 | 60% | 审架构取舍、定技术债边界 |
| 方案 → 代码 | 80% | 审 diff、定代码风格 |
| 代码 → 审查 | 90% | 高危改动人工兜底 |
| 代码 → 测试 | 85% | 定期望值、判断业务正确性 |
| 合并 → 部署 | 95% | 配密钥、审部署脚本 |
| 上线 → 监控 | 80% | 定告警阈值、判断是否回滚 |
规律很明显:越靠近「机械重复」的环节,AI 接得越多;越靠近「拍板决策」的环节,人的比例越高。 这不是巧合,是 AI 能力的真实边界——它擅长执行,不擅长负责。所以这套工作流的设计原则就是:让 AI 干执行的活,把决策的位置留给人。
三个坑
坑一:一条龙让 AI 从头写到尾,中间不看
最大的坑。AI 中途跑偏了,你到最后才发现,返工成本比省的时间还多。检查点就是为了拦住这种事——宁可每个环节多花两分钟确认,也别让错误滚雪球。
坑二:spec 写得比代码还长
spec 驱动的目的是「想清楚」,不是「写论文」。给 AI 写 PRD 的 prompt 里一定加一句「控制在 500 字以内」。文档一旦超过一屏,就没人真的会读,检查点就形同虚设。
坑三:上下文没管好,AI 在任务之间丢失记忆
多个任务连续做,AI 可能忘了前面任务改了哪些文件、定了什么约定。解决办法是每个任务开始前,把 spec 的路径和「当前进度」喂给它,让它先读一遍再动手。别指望它自己记住。
总结
这套工作流的本质,不是「让 AI 替你干活」,而是把 AI 变成你的团队。你从「写代码的人」变成「管代码的人」——写 PRD、拆任务、审方案、拍板合入,这些决策才是你的核心价值,剩下的执行交给 AI。
回顾这个系列:Prompt 让你学会怎么下指令,Debugging 让 AI 帮你定位问题,Code Review 让 AI 当你的第二双眼睛,Testing 让 AI 补上你懒得写的测试,这一篇把它们串成流水线。五篇合起来,就是一套完整的 AI 编程方法论。
记住一句话:AI 是高级接线员,不是总指挥。检查点永远握在人手里。
AI编程工具链系列:
1. Prompt Engineering 实战手册
2. AI Debugging:让AI帮你修bug
3. AI 代码审查:让AI帮你 Code Review
4. AI 自动化测试——从单元测试到 E2E
5. 👉 AI 驱动的完整开发工作流——从需求到上线(本文)
💬 Comments