AI编程工具链:AI 自动化测试——从单元测试到 E2E
测试是每个独立开发者「最想省掉」的代码
写测试这件事,独立开发者心里都清楚它重要,但就是不想写。为什么?因为写测试不产生新功能——用户看不见,进度却实打实地被拖慢。大厂有专门的 QA 团队、有覆盖率门槛卡着;你一个人写代码,测试大概率排在「有空再补」的清单最后,然后永远没空。
但测试省不得。你上一个功能改了五行,没跑测试就上线,结果另一个模块崩了。这种事故独立开发者最伤不起——没人给你兜底,出问题得自己半夜爬起来修。我在微软时见过太多「改了 A、崩了 B」的线上事故,几乎都是测试没覆盖到那个交叉点。
AI 恰好是写测试最好的帮手。写测试和写业务代码不一样:测试更「模板化」、更「确定性」、更「机械」,这正是 AI 最擅长的。你只要把被测函数和期望行为说清楚,AI 能把边界用例、异常路径、Mock 全给你补上,而且写得比你手动快十倍。
这篇文章讲怎么让 AI 帮你从单元测试一路写到 E2E,最后接进 CI 自动跑。
AI 写测试,擅长什么、不擅长什么
先把边界划清楚,别期望过高:
| 测试类型 | AI 表现 | 说明 |
|---|---|---|
| 单元测试(纯函数) | ⭐⭐⭐⭐⭐ | 输入输出明确,AI 几乎不用想 |
| 边界用例补全 | ⭐⭐⭐⭐⭐ | 空值、0、负数、超长字符串,AI 想得比人全 |
| 异常路径 / 错误处理 | ⭐⭐⭐⭐ | 需要你说清楚「什么算异常」 |
| 集成测试(DB / API) | ⭐⭐⭐⭐ | 要给出 schema 和接口契约 |
| Mock / 打桩 | ⭐⭐⭐⭐ | 给它依赖关系,它能搭好 |
| E2E 测试 | ⭐⭐⭐ | 选择器要稳定,AI 写的选择器常碎 |
| 用例的「业务正确性」 | ⭐⭐ | 期望值对不对,得你自己判断 |
一句话:AI 擅长「把测试写出来」,不擅长「判断测试写得对不对」。期望值、业务规则这些,最终要你拍板。
第一步:给老代码补单元测试
最实用的场景是给现有的、没有测试的代码补测试。直接上例子。这是我从某个订单系统扒出来的折扣计算函数:
def calculate_discount(order_total: float, user_level: str, coupon_code: str = None) -> float:
    """计算折后价。"""
    discount = 0.0
    if user_level == "vip":
        discount = 0.2
    elif user_level == "regular":
        discount = 0.1
    if coupon_code:
        discount += 0.05
    return round(order_total * (1 - discount), 2)
把它和一个测试生成 prompt 一起丢给 AI。prompt 我贴出来,可以直接复用:
给下面的函数写 pytest 单元测试。要求:
1. 覆盖所有分支(vip / regular / 无等级 / 有优惠券 / 无优惠券)
2. 补边界用例:0、负数、极小值、None
3. 用 @pytest.mark.parametrize 合并同类用例
4. 如果发现函数本身有 bug(比如折扣超过 100%、负数金额),明确指出来

函数:
[粘贴代码]
AI 返回的测试:
import pytest
from order import calculate_discount

def test_vip_20_percent():
    assert calculate_discount(100, "vip") == 80.0

def test_regular_10_percent():
    assert calculate_discount(100, "regular") == 90.0

def test_guest_no_discount():
    assert calculate_discount(100, "guest") == 100.0

def test_coupon_stacks_on_vip():
    assert calculate_discount(100, "vip", "SAVE5") == 75.0

@pytest.mark.parametrize("total", [0, -1, 0.01, 999999.99])
def test_extreme_totals(total):
    result = calculate_discount(total, "vip", "SAVE5")
    assert result is not None  # 至少不崩溃

def test_none_coupon_ignored():
    assert calculate_discount(100, "vip", None) == 80.0
它顺手还指出了两个函数本身的 bug:一是 order_total 为负数时照算不误,应该抛异常或返回 0;二是 VIP + 优惠券能叠到 25% 的折扣,如果业务上不允许叠加,这是个逻辑漏洞。
注意,第二个「bug」是业务问题,AI 只是提醒,对不对得你判断。但第一个是实打实的缺陷——没有 AI 补测试,你可能永远想不到有用户会传负数金额进来。
集成测试:让 AI 连数据库和 API
单元测试过了,接着是集成测试——验证你的代码和数据库、外部服务连起来还能不能跑。这部分 AI 也能写,前提是你把「契约」给它:接口的入参、返回结构、数据库表结构。
FastAPI 项目的例子。给 AI 一个接口定义:
这是 FastAPI 项目。帮我写集成测试,用 httpx 的 AsyncClient:
- POST /users  入参 {name, email},201 返回 {id, name, email}
- GET /users/{id}  200 返回用户,404 返回 {detail: "not found"}
用测试数据库,每个测试用 fixture 清理数据。
AI 生成:
import pytest
from httpx import AsyncClient
from app.main import app
from app.db import engine, Base

@pytest.fixture(autouse=True)
async def clean_db():
    async with engine.begin() as conn:
        await conn.run_sync(Base.metadata.drop_all)
        await conn.run_sync(Base.metadata.create_all)

@pytest.mark.asyncio
async def test_create_and_get_user():
    async with AsyncClient(app=app, base_url="http://test") as client:
        resp = await client.post("/users", json={"name": "zhouyang", "email": "z@example.com"})
        assert resp.status_code == 201
        user_id = resp.json()["id"]

        got = await client.get(f"/users/{user_id}")
        assert got.status_code == 200
        assert got.json()["name"] == "zhouyang"

@pytest.mark.asyncio
async def test_get_missing_user_404():
    async with AsyncClient(app=app, base_url="http://test") as client:
        resp = await client.get("/users/99999")
        assert resp.status_code == 404
        assert resp.json()["detail"] == "not found"
集成测试的关键是让 AI 看到 schema 和接口文档。信息给得越全,它写的测试越准,跑一次就过的概率越高。
E2E 测试:Playwright 让 AI 生成
最顶层的 E2E 测试模拟真实用户操作。这里最顺手的是 Playwright——AI 甚至能给你生成带定位器的完整脚本。但注意,E2E 是 AI 表现最弱的一层,选择器经常碎,需要你自己跑一遍微调。
给 AI 一个场景描述:
用 Playwright (Python, sync API) 写一个登录 E2E 测试:
1. 打开 /login
2. 填入邮箱和密码
3. 点提交
4. 断言跳转到 /dashboard,页面包含 "欢迎回来"
AI 生成:
from playwright.sync_api import sync_playwright, expect

def test_login_flow():
    with sync_playwright() as p:
        browser = p.chromium.launch()
        page = browser.new_page()
        page.goto("http://localhost:3000/login")
        page.fill("input[name=email]", "test@example.com")
        page.fill("input[name=password]", "secret123")
        page.click("button[type=submit]")
        expect(page).to_have_url("http://localhost:3000/dashboard")
        expect(page.locator("h1")).to_contain_text("欢迎回来")
        browser.close()
E2E 的价值不在覆盖多少,而在守住几条「用户最核心的路径」——注册、登录、下单、支付。这几条路一旦断了,影响的是真金白银。AI 帮你把骨架搭出来,你花十分钟调选择器,比从头写省太多。
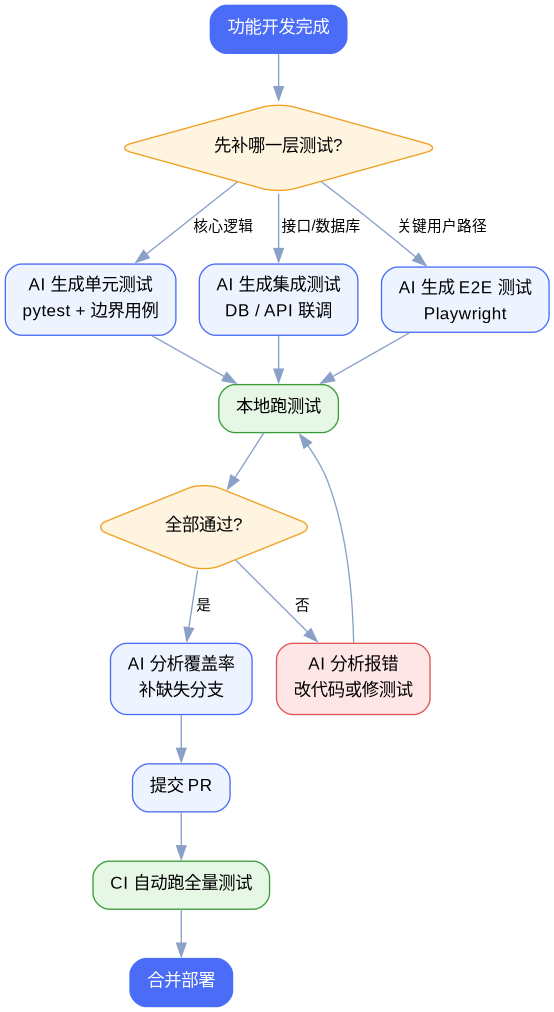
整个流程画成一张图,方便你对照:
从 bug 反推测试:让 AI 写回归测试
AI 写测试最高级的用法,是「从 bug 反推测试」。线上出了一个 bug,修完之后让 AI 把 bug 场景固化成一条回归测试,保证它永远不再复发。
比如线上报了个问题:订单金额为 0 时,结算接口直接 500 了。修完之后,让 AI 写回归测试:
我们刚修了一个 bug:订单金额为 0 时,结算接口 /checkout 会 500。
现在修好了(返回 400 + 提示)。写一条回归测试锁定这个场景,防止将来再犯。
AI 生成:
@pytest.mark.asyncio
async def test_checkout_zero_amount_returns_400():
    async with AsyncClient(app=app, base_url="http://test") as client:
        resp = await client.post("/checkout", json={"order_id": 1, "amount": 0})
        assert resp.status_code == 400
        assert "金额" in resp.json()["detail"]
这条测试的注释里写清楚它对应哪个 bug,半年后有人删掉它,一看注释就知道为什么不能删。这个习惯比覆盖率数字值钱得多。
覆盖率不是 KPI
补测试的人最容易掉进一个坑:追求 100% 覆盖率。AI 能帮你把覆盖率刷上去,但那没有意义——覆盖了不代表测对了,一行代码被执行到,和这行代码的行为被验证是两回事。
我给自己定的规矩是:核心逻辑(钱相关的计算、鉴权、数据迁移)必须高覆盖,并且测试要「断言具体值」而不是「断言不崩溃」;边缘的胶水代码,覆盖不覆盖无所谓。
所以 AI 分析覆盖率时,我让它只关注「没覆盖到的关键分支」,而不是「把数字刷满」:
跑一下 pytest --cov,然后只列出核心模块里没被覆盖的分支,别管覆盖率百分比。
对每个没覆盖的分支,说明它是什么场景,值得不值得补测试。
接进 CI,每次提交自动跑
测试写完了,最后一步是让它自动跑起来,否则你还是会忘。GitHub Actions 一个最小配置:
# .github/workflows/test.yml
name: Tests
on: [push, pull_request]
jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with:
          python-version: "3.11"
      - run: pip install -r requirements.txt pytest pytest-cov
      - run: pytest --cov=app --cov-report=term-missing
配好之后,每次 push 自动跑全量测试,挂了 merge 按钮直接变红。这跟你上一篇搭的 AI 代码审查正好串成一条线:CI 里 AI 审一遍 diff,机器跑一遍测试,两道门都过了才让合并。
三个坑
坑一:让 AI 写测试,但不给它「期望值」
测试的灵魂是断言里的期望值。你不告诉 AI「什么是对的」,它就只能断言「不报错」,这种测试是空壳。给 prompt 时,务必把业务规则写清楚。
坑二:AI 写的测试全绿,就以为代码没问题
测试全绿只能说明「测试没发现 bug」,不能说明「没有 bug」。AI 可能漏测了关键分支,也可能把期望值写错了(连 bug 一起「验证」为正确)。核心逻辑的测试,期望值你自己过一遍。
坑三:E2E 测试的选择器直接照抄
AI 生成的 CSS 选择器经常太脆——页面一改样式就碎。E2E 测试里尽量用 data-testid 这种稳定的属性,让 AI 写测试时也用这个约定,能少踩很多坑。
总结
AI 帮你写测试,最大的价值不是「多写了几个测试」,而是把「该写测试却没写」这个最普遍的人性问题解决了——因为写测试的边际成本被 AI 打到几乎为零。
- 单元测试是 AI 的主场,边界用例让它放开补
- 集成测试要给足 schema 和接口契约
- E2E 守住核心路径,选择器用
data-testid稳定化 - 从 bug 反推回归测试,比覆盖率数字更有价值
- 接进 CI 自动跑,和 AI 代码审查串成闭环
下一篇是这个系列的最后一篇:把这些东西串起来,讲一套 AI 驱动的完整开发工作流——从需求到上线,AI 在每个环节到底能接多少活。
AI编程工具链系列:
1. Prompt Engineering 实战手册
2. AI Debugging:让AI帮你修bug
3. AI 代码审查:让AI帮你 Code Review
4. 👉 AI 自动化测试——从单元测试到 E2E(本文)
5. AI 驱动的完整开发工作流——从需求到上线
💬 Comments